喜歡寫代碼的群友們妳們好。
去年的這個時候我就已經在玩編譯器了,我在筆記 👉🏻編譯器學習記錄1️⃣:人肉卡西歐計算器 中提到,我正在學習怎麼手撕虛擬執行環境,然而空手並不能敲開 VM 的大門,我必須先去爬一點解釋器(和編譯器)的知識。
當時的萬里 “長征” 剛到一半,我就被其他東西奪走了注意力 😅 目前我的水平距離前輩們的高度仍然相去甚遠,但是 學以致用 這一塊可不能丟下啊,因此我決定充分利用現有的知識,探索一個我比較感興趣的領域:
代碼混淆 😎
Contents
前言:玩弄編程語言
上輩子我花了一個半月學會了怎麼「玩弄編程語言」,包括怎麼解析數學表達式的語法,比如下面的式子:
就可以解析成語法樹如下:
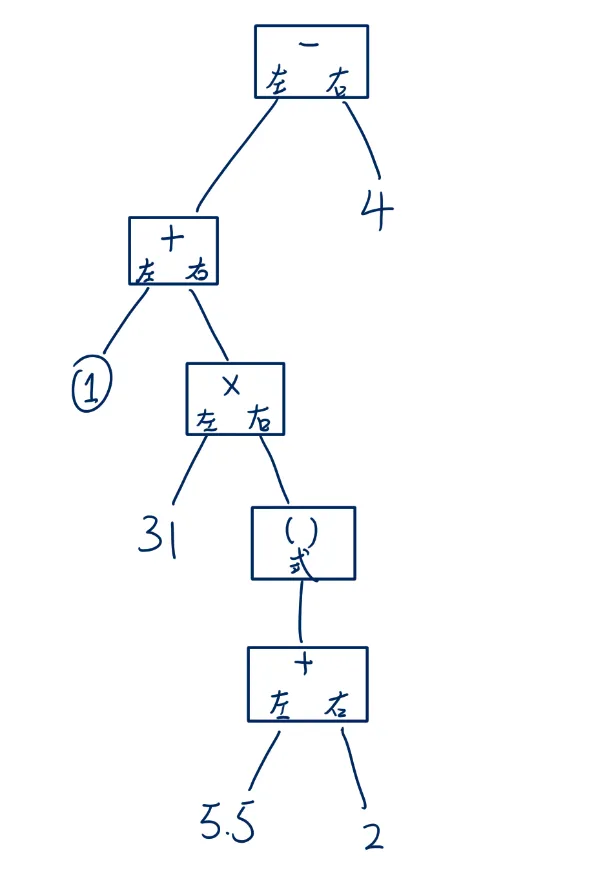
卡西歐計算器就是靠着這棵樹來理解數學式,並進行運算的。
但是不幸的是,我在做完上述了 AST walker 之後就荒廢了一年,沒能在編譯器這塊做出任何推進,,,
在棄坑一週年之際,死去的記憶它復活了!我現在非常想研究一下代碼混淆的領域!
這時候有的群友可能要問了:代碼混淆和編譯器有何關係呢?為了回答這個問題,我們需要瞭解一下編譯器的工作流程:
%3btext-align:center%3b%7d%23mermaid-chart-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-0 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-0 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-0 .icon-shape%2c%23mermaid-chart-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-0 .icon-shape p%2c%23mermaid-chart-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-0 .icon-shape .label rect%2c%23mermaid-chart-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-0 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-0 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M481.664%2c47L481.664%2c51.167C481.664%2c55.333%2c481.664%2c63.667%2c481.664%2c71.333C481.664%2c79%2c481.664%2c86%2c481.664%2c89.5L481.664%2c93' id='mermaid-chart-0-e1' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e1' data-points='W3sieCI6NDgxLjY2NDA2MjUsInkiOjQ3fSx7IngiOjQ4MS42NjQwNjI1LCJ5Ijo3Mn0seyJ4Ijo0ODEuNjY0MDYyNSwieSI6OTd9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M481.664%2c245L481.664%2c249.167C481.664%2c253.333%2c481.664%2c261.667%2c481.664%2c269.333C481.664%2c277%2c481.664%2c284%2c481.664%2c287.5L481.664%2c291' id='mermaid-chart-0-e2' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e2' data-points='W3sieCI6NDgxLjY2NDA2MjUsInkiOjI0NX0seyJ4Ijo0ODEuNjY0MDYyNSwieSI6MjcwfSx7IngiOjQ4MS42NjQwNjI1LCJ5IjoyOTV9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M481.664%2c373L481.664%2c377.167C481.664%2c381.333%2c481.664%2c389.667%2c481.664%2c397.333C481.664%2c405%2c481.664%2c412%2c481.664%2c415.5L481.664%2c419' id='mermaid-chart-0-e3' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e3' data-points='W3sieCI6NDgxLjY2NDA2MjUsInkiOjM3M30seyJ4Ijo0ODEuNjY0MDYyNSwieSI6Mzk4fSx7IngiOjQ4MS42NjQwNjI1LCJ5Ijo0MjN9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M481.664%2c547L481.664%2c551.167C481.664%2c555.333%2c481.664%2c563.667%2c481.664%2c571.333C481.664%2c579%2c481.664%2c586%2c481.664%2c589.5L481.664%2c593' id='mermaid-chart-0-e4' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e4' data-points='W3sieCI6NDgxLjY2NDA2MjUsInkiOjU0N30seyJ4Ijo0ODEuNjY0MDYyNSwieSI6NTcyfSx7IngiOjQ4MS42NjQwNjI1LCJ5Ijo1OTd9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e1' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e2' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e3' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e4' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='root' transform='translate(0%2c 415)'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-chart-0-Backend' data-look='classic'%3e%3crect style='' x='8' y='8' width='947.328125' height='124'/%3e%3cg class='cluster-label' transform='translate(294.625%2c 8)'%3e%3cforeignObject width='374.078125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%b7%a8%e8%ad%af%e5%99%a8%e5%be%8c%e7%ab%af (Optimization %26amp%3b Target Code Generation)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M121.5%2c70L127.75%2c70C134%2c70%2c146.5%2c70%2c158.333%2c70C170.167%2c70%2c181.333%2c70%2c186.917%2c70L192.5%2c70' id='mermaid-chart-0-L_IR2_IS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_IR2_IS_0' data-points='W3sieCI6MTIxLjUsInkiOjcwfSx7IngiOjE1OSwieSI6NzB9LHsieCI6MTk2LjUsInkiOjcwfV0=' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M400.578%2c70L406.828%2c70C413.078%2c70%2c425.578%2c70%2c437.411%2c70C449.245%2c70%2c460.411%2c70%2c465.995%2c70L471.578%2c70' id='mermaid-chart-0-L_IS_RA_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_IS_RA_0' data-points='W3sieCI6NDAwLjU3ODEyNSwieSI6NzB9LHsieCI6NDM4LjA3ODEyNSwieSI6NzB9LHsieCI6NDc1LjU3ODEyNSwieSI6NzB9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M668.094%2c70L674.344%2c70C680.594%2c70%2c693.094%2c70%2c704.927%2c70C716.76%2c70%2c727.927%2c70%2c733.51%2c70L739.094%2c70' id='mermaid-chart-0-L_RA_CodeGen_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_RA_CodeGen_0' data-points='W3sieCI6NjY4LjA5Mzc1LCJ5Ijo3MH0seyJ4Ijo3MDUuNTkzNzUsInkiOjcwfSx7IngiOjc0My4wOTM3NSwieSI6NzB9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_IR2_IS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_IS_RA_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_RA_CodeGen_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-0-flowchart-IR2-8' data-look='classic' transform='translate(83.5%2c 70)'%3e%3crect class='basic label-container' style='' x='-38' y='-27' width='76' height='54'/%3e%3cg class='label' style='' transform='translate(-8%2c -12)'%3e%3crect/%3e%3cforeignObject width='16' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIR%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-IS-9' data-look='classic' transform='translate(298.5390625%2c 70)'%3e%3crect class='basic label-container' style='' x='-102.0390625' y='-27' width='204.078125' height='54'/%3e%3cg class='label' style='' transform='translate(-72.0390625%2c -12)'%3e%3crect/%3e%3cforeignObject width='144.078125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eInstruction Selection%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-RA-11' data-look='classic' transform='translate(571.8359375%2c 70)'%3e%3crect class='basic label-container' style='' x='-96.2578125' y='-27' width='192.515625' height='54'/%3e%3cg class='label' style='' transform='translate(-66.2578125%2c -12)'%3e%3crect/%3e%3cforeignObject width='132.515625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRegister Allocation%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-CodeGen-13' data-look='classic' transform='translate(830.4609375%2c 70)'%3e%3crect class='basic label-container' style='' x='-87.3671875' y='-27' width='174.734375' height='54'/%3e%3cg class='label' style='' transform='translate(-57.3671875%2c -12)'%3e%3crect/%3e%3cforeignObject width='114.734375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCode Generator%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='root' transform='translate(6.234375%2c 89)'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-chart-0-Frontend' data-look='classic'%3e%3crect style='' x='8' y='8' width='934.859375' height='148'/%3e%3cg class='cluster-label' transform='translate(318.1953125%2c 8)'%3e%3cforeignObject width='314.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%b7%a8%e8%ad%af%e5%99%a8%e5%89%8d%e7%ab%af (Analysis %26amp%3b Semantic Validation)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M212.219%2c82L218.469%2c82C224.719%2c82%2c237.219%2c82%2c249.052%2c82C260.885%2c82%2c272.052%2c82%2c277.635%2c82L283.219%2c82' id='mermaid-chart-0-L_LP_RawAST_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_LP_RawAST_0' data-points='W3sieCI6MjEyLjIxODc1LCJ5Ijo4Mn0seyJ4IjoyNDkuNzE4NzUsInkiOjgyfSx7IngiOjI4Ny4yMTg3NSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M413.906%2c82L420.156%2c82C426.406%2c82%2c438.906%2c82%2c450.74%2c82C462.573%2c82%2c473.74%2c82%2c479.323%2c82L484.906%2c82' id='mermaid-chart-0-L_RawAST_NRB_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_RawAST_NRB_0' data-points='W3sieCI6NDEzLjkwNjI1LCJ5Ijo4Mn0seyJ4Ijo0NTEuNDA2MjUsInkiOjgyfSx7IngiOjQ4OC45MDYyNSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M671.641%2c82L677.891%2c82C684.141%2c82%2c696.641%2c82%2c708.474%2c82C720.307%2c82%2c731.474%2c82%2c737.057%2c82L742.641%2c82' id='mermaid-chart-0-L_NRB_TC_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_NRB_TC_0' data-points='W3sieCI6NjcxLjY0MDYyNSwieSI6ODJ9LHsieCI6NzA5LjE0MDYyNSwieSI6ODJ9LHsieCI6NzQ2LjY0MDYyNSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_LP_RawAST_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_RawAST_NRB_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_NRB_TC_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-0-flowchart-LP-1' data-look='classic' transform='translate(128.859375%2c 82)'%3e%3crect class='basic label-container' style='' x='-83.359375' y='-27' width='166.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-53.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='106.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eLexer %26amp%3b Parser%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-RawAST-2' data-look='classic' transform='translate(350.5625%2c 82)'%3e%3crect class='basic label-container' style='' x='-63.34375' y='-27' width='126.6875' height='54'/%3e%3cg class='label' style='' transform='translate(-33.34375%2c -12)'%3e%3crect/%3e%3cforeignObject width='66.6875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRaw AST%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-NRB-4' data-look='classic' transform='translate(580.2734375%2c 82)'%3e%3crect class='basic label-container' style='' x='-91.3671875' y='-39' width='182.734375' height='78'/%3e%3cg class='label' style='' transform='translate(-61.3671875%2c -24)'%3e%3crect/%3e%3cforeignObject width='122.734375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eName Resolution %3cbr /%3e Binding%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-TC-6' data-look='classic' transform='translate(826%2c 82)'%3e%3crect class='basic label-container' style='' x='-79.359375' y='-27' width='158.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-49.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='98.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eType Checker%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-Source-0' data-look='classic' transform='translate(481.6640625%2c 27.5)'%3e%3cpolygon points='-19.5%2c0 108.390625%2c0 127.890625%2c-39 0%2c-39' class='label-container' transform='translate(-54.1953125%2c19.5)'/%3e%3cg class='label' style='' transform='translate(-46.6953125%2c -12)'%3e%3crect/%3e%3cforeignObject width='93.390625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSource Code%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-IR-7' data-look='classic' transform='translate(481.6640625%2c 334)'%3e%3crect class='basic label-container' style='' x='-130' y='-39' width='260' height='78'/%3e%3cg class='label' style='' transform='translate(-100%2c -24)'%3e%3crect/%3e%3cforeignObject width='200' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIntermediate Representation (IR)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-0-flowchart-Target-14' data-look='classic' transform='translate(481.6640625%2c 616.5)'%3e%3cpolygon points='-19.5%2c0 167.09375%2c0 186.59375%2c-39 0%2c-39' class='label-container' transform='translate(-83.546875%2c19.5)'/%3e%3cg class='label' style='' transform='translate(-76.046875%2c -12)'%3e%3crect/%3e%3cforeignObject width='152.09375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eTarget Machine Code%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
編譯器的工作是將源代碼轉換為機器可以執行的形式,這種轉換並非一步登天,而是由如同上圖中的一整套流水線組成。圖中專有名詞和術語衆多,看不明白也不要緊,我也只是懂到 Binding 那一步而已,其實每一個步驟說白了都可以當作代碼的分析/變形/轉換。
由於代碼混淆只是一種代碼變形,所以我們自然而然就能想到,代碼混淆可以作為一個步驟插入編譯流水線之中。之後再經過這套步驟編譯出的程序,就是功能不變,但代碼已經被混淆過的程序了。
這我我要研究的代碼混淆手法就是大名鼎鼎、淵遠流長的 控制流拍平 (Control Flow Flattening)。接下來使用編程語言玩弄編程語言的旅程即將開始,請小心自己的大腦遭到玩弄……
1/ 代碼混淆初探
代碼混淆是程序保護的一部分,而提到程序保護,我相信很多群友想到的都是名如「xx 殼」的加殼保護器。加殼一般指的是加密一個已經編譯好的程序,然後在啓動的時候才動態解密,釋放並運行。然而程序保護的含義更廣,這個詞不僅包括了編譯之後的加殼,也包括了在編譯的過程中就對程序代碼進行變形,還包括了在程序中人為插入各種驗證之類的,保護程序不被篡改的做法。
本文中的「代碼混淆」主要指的是在編譯過程中對代碼進行變形,在保證程序功能不變的情況下,這種變形使得程序在源代碼這一步上就難以閱讀,也使得編譯產物更加複雜,屬於是一種從源頭上扼殺的手法。而且對於一些基本沒法編譯、天生就開源的語言——JavaScript 和 Python,代碼混淆是最重要的一種保護工具。
網上有很多開源的代碼混淆器,JavaScript 這邊有一個歷史悠久 (十年!) 的混淆器 👉🏻javascript-obfuscator,它就提供了幾十種混淆手法可供學習:
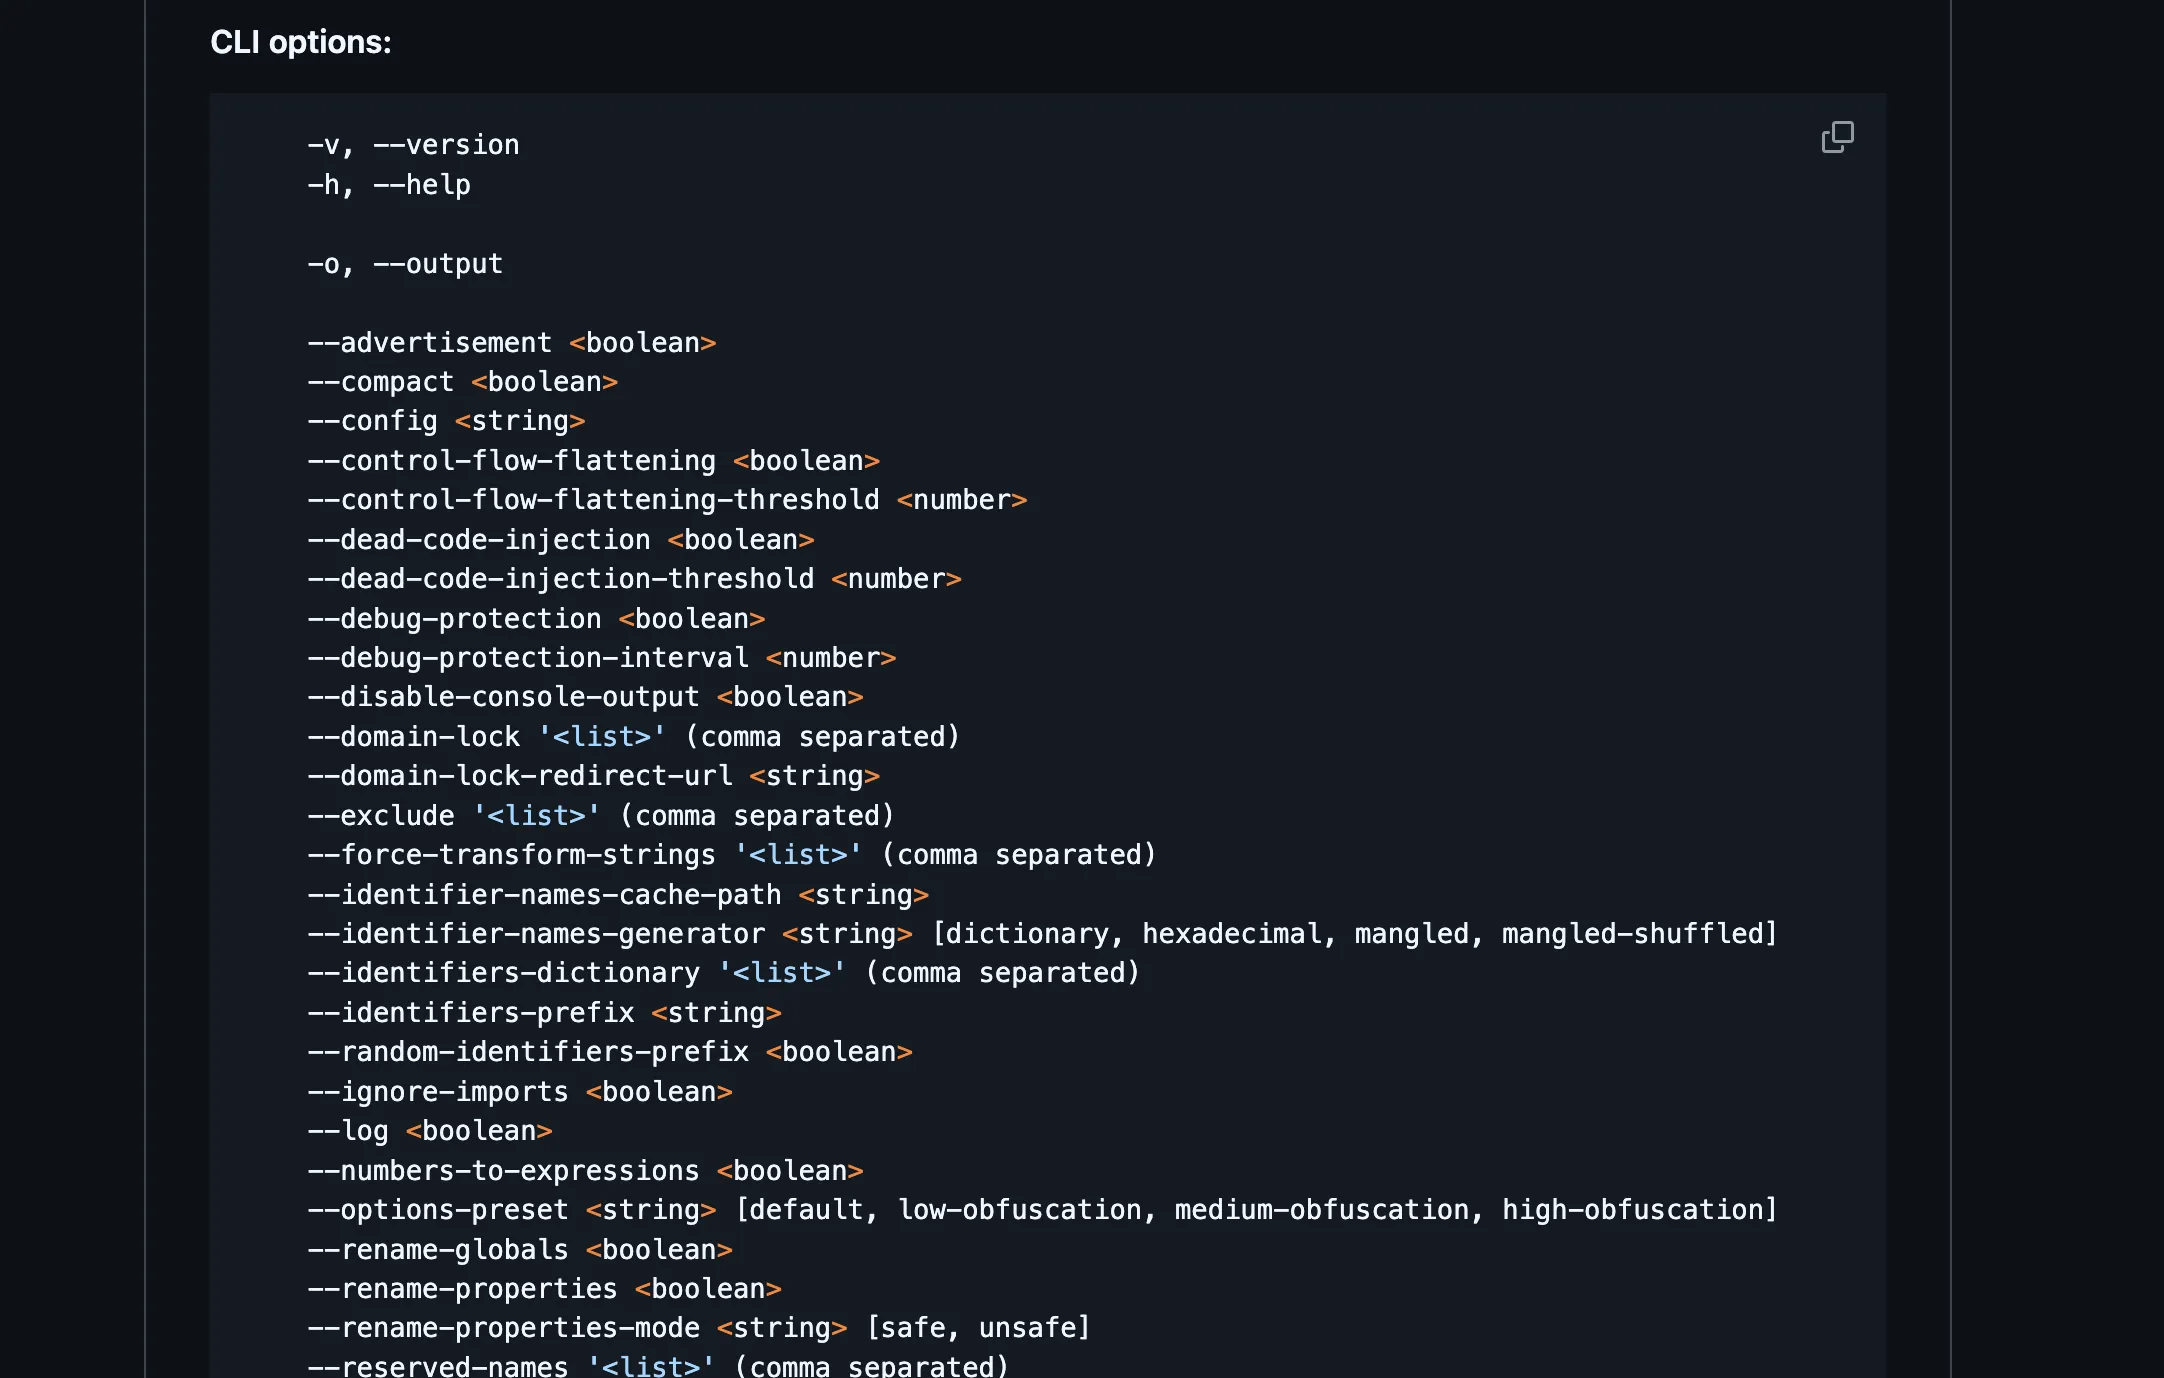
要是把圖中這些選項全部舔一遍的話要花三天三夜,不過我們還是可以通過觀察一些典型的手法來一探究竟。另一個我很喜歡的混淆器項目叫做 👉🏻O-MVLL,它通過直接插入 LLVM 的編譯過程來改變代碼,而且他們的網站做得很不錯,提供了不少混淆前後的代碼示例,下面我挑兩個來展示:
1. 混淆數學運算 (Arithmetic Obfuscation)
這個手法可以將簡單的數學運算故意複雜化,原運算形如:
int add = x + y;
int sub = x - y;
int xor = x ^ y;
就可以強行改寫成下面的形式,而且計算結果完全不變:
int add = (x & y) + (x | y);
int sub = (x ^ -y) + 2*(x & -y);
int xor = (x | y) - (x & y);
把這個過程套娃幾層,很快就辨別不了原來的運算形式了。
2. 不透明謂詞 (Opaque Predicates)
在代碼中插入一些只有我才知道運算結果的複雜運算,並以運算結果來控制程序走向。而由於妳並不知道結果如何,導致無法輕易推斷程序的走向。假設有一個程序如下:
def hello_world():
  print("hellw world")
加入一點不透明謂詞就變成了:
def hello_world():
    x = 8341
    y = random.randint(0, 9999)
    if ((x & y) + (x | y))**((x | x) - (x & x)) == (y ^ -y) + 2*(y & -y) + 1:
        print("hellw world")
    else:
        os.remove("C:\\Windows\\System32")
編寫程序的人(我)事先知道 if 永遠為真,可是逆向程序的人(妳)卻不知道,所以妳沒法一眼看出這個程序的去向如何。
除此之外還有其他多種混淆手法,要是在編譯的時候愛加多加,編譯出來的程序就🈶️了。不過以上的都還只是小魚小蝦,接下來要介紹的才是本文的主角,也是我最喜歡的一個手法:控制流拍平。
控制流指的就是程序的走向。剛才那個有 if 的程序,它的控制流就是這樣的:
%3btext-align:center%3b%7d%23mermaid-chart-1 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-1 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-1 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-1 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-1 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-1 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-1 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-1 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-1 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-1 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-1 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-1 .icon-shape%2c%23mermaid-chart-1 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-1 .icon-shape p%2c%23mermaid-chart-1 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-1 .icon-shape .label rect%2c%23mermaid-chart-1 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-1 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-1 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-1 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-1 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-1 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-1 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-1 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M219.387%2c62L219.387%2c66.167C219.387%2c70.333%2c219.387%2c78.667%2c219.387%2c86.333C219.387%2c94%2c219.387%2c101%2c219.387%2c104.5L219.387%2c108' id='mermaid-chart-1-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjE5LjM4NjcxODc1LCJ5Ijo2Mn0seyJ4IjoyMTkuMzg2NzE4NzUsInkiOjg3fSx7IngiOjIxOS4zODY3MTg3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M168.351%2c166L156.695%2c172.167C145.039%2c178.333%2c121.727%2c190.667%2c110.07%2c202.333C98.414%2c214%2c98.414%2c225%2c98.414%2c230.5L98.414%2c236' id='mermaid-chart-1-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MTY4LjM1MTM3OTM5NDUzMTI1LCJ5IjoxNjZ9LHsieCI6OTguNDE0MDYyNSwieSI6MjAzfSx7IngiOjk4LjQxNDA2MjUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M270.422%2c166L282.078%2c172.167C293.734%2c178.333%2c317.047%2c190.667%2c328.703%2c202.333C340.359%2c214%2c340.359%2c225%2c340.359%2c230.5L340.359%2c236' id='mermaid-chart-1-L_B_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_D_0' data-points='W3sieCI6MjcwLjQyMjA1ODEwNTQ2ODc1LCJ5IjoxNjZ9LHsieCI6MzQwLjM1OTM3NSwieSI6MjAzfSx7IngiOjM0MC4zNTkzNzUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M98.414%2c294L98.414%2c298.167C98.414%2c302.333%2c98.414%2c310.667%2c107.495%2c318.737C116.576%2c326.807%2c134.737%2c334.614%2c143.818%2c338.517L152.899%2c342.42' id='mermaid-chart-1-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6OTguNDE0MDYyNSwieSI6Mjk0fSx7IngiOjk4LjQxNDA2MjUsInkiOjMxOX0seyJ4IjoxNTYuNTczOTkzMzg5NDIzMSwieSI6MzQ0fV0=' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M340.359%2c294L340.359%2c298.167C340.359%2c302.333%2c340.359%2c310.667%2c331.279%2c318.737C322.198%2c326.807%2c304.036%2c334.614%2c294.955%2c338.517L285.874%2c342.42' id='mermaid-chart-1-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MzQwLjM1OTM3NSwieSI6Mjk0fSx7IngiOjM0MC4zNTkzNzUsInkiOjMxOX0seyJ4IjoyODIuMTk5NDQ0MTEwNTc2OSwieSI6MzQ0fV0=' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M219.387%2c398L219.387%2c402.167C219.387%2c406.333%2c219.387%2c414.667%2c219.387%2c422.333C219.387%2c430%2c219.387%2c437%2c219.387%2c440.5L219.387%2c444' id='mermaid-chart-1-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MjE5LjM4NjcxODc1LCJ5IjozOTh9LHsieCI6MjE5LjM4NjcxODc1LCJ5Ijo0MjN9LHsieCI6MjE5LjM4NjcxODc1LCJ5Ijo0NDh9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(98.4140625%2c 203)'%3e%3cg class='label' data-id='L_B_C_0' transform='translate(-16.15625%2c -12)'%3e%3cforeignObject width='32.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eTrue%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(340.359375%2c 203)'%3e%3cg class='label' data-id='L_B_D_0' transform='translate(-19.5625%2c -12)'%3e%3cforeignObject width='39.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eFalse%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_C_E_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-1-flowchart-A-0' data-look='classic' transform='translate(219.38671875%2c 35)'%3e%3crect class='basic label-container' style='' x='-46.8984375' y='-27' width='93.796875' height='54'/%3e%3cg class='label' style='' transform='translate(-16.8984375%2c -12)'%3e%3crect/%3e%3cforeignObject width='33.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eStart%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-1-flowchart-B-1' data-look='classic' transform='translate(219.38671875%2c 139)'%3e%3crect class='basic label-container' style='' x='-97.15625' y='-27' width='194.3125' height='54'/%3e%3cg class='label' style='' transform='translate(-67.15625%2c -12)'%3e%3crect/%3e%3cforeignObject width='134.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEvaluate Condition%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-1-flowchart-C-3' data-look='classic' transform='translate(98.4140625%2c 267)'%3e%3crect class='basic label-container' style='' x='-90.4140625' y='-27' width='180.828125' height='54'/%3e%3cg class='label' style='' transform='translate(-60.4140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='120.828125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eExecute 'If' Block%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-1-flowchart-D-5' data-look='classic' transform='translate(340.359375%2c 267)'%3e%3crect class='basic label-container' style='' x='-101.53125' y='-27' width='203.0625' height='54'/%3e%3cg class='label' style='' transform='translate(-71.53125%2c -12)'%3e%3crect/%3e%3cforeignObject width='143.0625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eExecute 'Else' Block%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-1-flowchart-E-7' data-look='classic' transform='translate(219.38671875%2c 371)'%3e%3crect class='basic label-container' style='' x='-99.3828125' y='-27' width='198.765625' height='54'/%3e%3cg class='label' style='' transform='translate(-69.3828125%2c -12)'%3e%3crect/%3e%3cforeignObject width='138.765625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eContinue Execution%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-1-flowchart-F-11' data-look='classic' transform='translate(219.38671875%2c 475)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEnd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-1-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-1-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
帶有循環的代碼控制流可能長這樣:
%3btext-align:center%3b%7d%23mermaid-chart-2 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-2 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-2 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-2 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-2 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-2 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-2 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-2 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-2 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-2 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-2 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-2 .icon-shape%2c%23mermaid-chart-2 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-2 .icon-shape p%2c%23mermaid-chart-2 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-2 .icon-shape .label rect%2c%23mermaid-chart-2 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-2 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-2 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-2 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-2 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-2 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-2 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-2 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M333.398%2c62L333.398%2c66.167C333.398%2c70.333%2c333.398%2c78.667%2c333.398%2c86.333C333.398%2c94%2c333.398%2c101%2c333.398%2c104.5L333.398%2c108' id='mermaid-chart-2-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MzMzLjM5ODQzNzUsInkiOjYyfSx7IngiOjMzMy4zOTg0Mzc1LCJ5Ijo4N30seyJ4IjozMzMuMzk4NDM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M333.398%2c166L333.398%2c170.167C333.398%2c174.333%2c333.398%2c182.667%2c333.398%2c190.333C333.398%2c198%2c333.398%2c205%2c333.398%2c208.5L333.398%2c212' id='mermaid-chart-2-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzMzLjM5ODQzNzUsInkiOjE2Nn0seyJ4IjozMzMuMzk4NDM3NSwieSI6MTkxfSx7IngiOjMzMy4zOTg0Mzc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M231.667%2c270L208.432%2c276.167C185.197%2c282.333%2c138.728%2c294.667%2c115.493%2c306.333C92.258%2c318%2c92.258%2c329%2c92.258%2c334.5L92.258%2c340' id='mermaid-chart-2-L_C_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_G_0' data-points='W3sieCI6MjMxLjY2NzIzNjMyODEyNSwieSI6MjcwfSx7IngiOjkyLjI1NzgxMjUsInkiOjMwN30seyJ4Ijo5Mi4yNTc4MTI1LCJ5IjozNDR9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M333.398%2c270L333.398%2c276.167C333.398%2c282.333%2c333.398%2c294.667%2c333.398%2c306.333C333.398%2c318%2c333.398%2c329%2c333.398%2c334.5L333.398%2c340' id='mermaid-chart-2-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MzMzLjM5ODQzNzUsInkiOjI3MH0seyJ4IjozMzMuMzk4NDM3NSwieSI6MzA3fSx7IngiOjMzMy4zOTg0Mzc1LCJ5IjozNDR9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M363.979%2c398L370.964%2c404.167C377.949%2c410.333%2c391.918%2c422.667%2c398.902%2c434.333C405.887%2c446%2c405.887%2c457%2c405.887%2c462.5L405.887%2c468' id='mermaid-chart-2-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MzYzLjk3OTQzMTE1MjM0Mzc1LCJ5IjozOTh9LHsieCI6NDA1Ljg4NjcxODc1LCJ5Ijo0MzV9LHsieCI6NDA1Ljg4NjcxODc1LCJ5Ijo0NzJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M302.817%2c398L295.833%2c404.167C288.848%2c410.333%2c274.879%2c422.667%2c267.895%2c439.5C260.91%2c456.333%2c260.91%2c477.667%2c260.91%2c497C260.91%2c516.333%2c260.91%2c533.667%2c271.776%2c546.273C282.642%2c558.879%2c304.374%2c566.758%2c315.24%2c570.697L326.106%2c574.637' id='mermaid-chart-2-L_D_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_F_0' data-points='W3sieCI6MzAyLjgxNzQ0Mzg0NzY1NjI1LCJ5IjozOTh9LHsieCI6MjYwLjkxMDE1NjI1LCJ5Ijo0MzV9LHsieCI6MjYwLjkxMDE1NjI1LCJ5Ijo0OTl9LHsieCI6MjYwLjkxMDE1NjI1LCJ5Ijo1NTF9LHsieCI6MzI5Ljg2NjczNjc3ODg0NjIsInkiOjU3Nn1d' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M405.887%2c526L405.887%2c530.167C405.887%2c534.333%2c405.887%2c542.667%2c405.783%2c550.334C405.678%2c558.001%2c405.47%2c565.001%2c405.366%2c568.501L405.262%2c572.002' id='mermaid-chart-2-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6NDA1Ljg4NjcxODc1LCJ5Ijo1MjZ9LHsieCI6NDA1Ljg4NjcxODc1LCJ5Ijo1NTF9LHsieCI6NDA1LjE0MzAyODg0NjE1Mzg3LCJ5Ijo1NzZ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M474.537%2c576L485.37%2c571.833C496.203%2c567.667%2c517.869%2c559.333%2c528.702%2c546.5C539.535%2c533.667%2c539.535%2c516.333%2c539.535%2c497C539.535%2c477.667%2c539.535%2c456.333%2c539.535%2c435C539.535%2c413.667%2c539.535%2c392.333%2c539.535%2c371C539.535%2c349.667%2c539.535%2c328.333%2c520.31%2c311.698C501.084%2c295.062%2c462.633%2c283.124%2c443.408%2c277.155L424.182%2c271.186' id='mermaid-chart-2-L_F_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_C_0' data-points='W3sieCI6NDc0LjUzNzQwOTg1NTc2OTIsInkiOjU3Nn0seyJ4Ijo1MzkuNTM1MTU2MjUsInkiOjU1MX0seyJ4Ijo1MzkuNTM1MTU2MjUsInkiOjQ5OX0seyJ4Ijo1MzkuNTM1MTU2MjUsInkiOjQzNX0seyJ4Ijo1MzkuNTM1MTU2MjUsInkiOjM3MX0seyJ4Ijo1MzkuNTM1MTU2MjUsInkiOjMwN30seyJ4Ijo0MjAuMzYyMzY1NzIyNjU2MjUsInkiOjI3MH1d' data-look='classic' marker-end='url(%23mermaid-chart-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(92.2578125%2c 307)'%3e%3cg class='label' data-id='L_C_G_0' transform='translate(-19.5625%2c -12)'%3e%3cforeignObject width='39.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eFalse%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(333.3984375%2c 307)'%3e%3cg class='label' data-id='L_C_D_0' transform='translate(-16.15625%2c -12)'%3e%3cforeignObject width='32.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eTrue%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(405.88671875%2c 435)'%3e%3cg class='label' data-id='L_D_E_0' transform='translate(-16.15625%2c -12)'%3e%3cforeignObject width='32.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eTrue%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(260.91015625%2c 499)'%3e%3cg class='label' data-id='L_D_F_0' transform='translate(-19.5625%2c -12)'%3e%3cforeignObject width='39.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eFalse%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_F_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-2-flowchart-A-0' data-look='classic' transform='translate(333.3984375%2c 35)'%3e%3crect class='basic label-container' style='' x='-46.8984375' y='-27' width='93.796875' height='54'/%3e%3cg class='label' style='' transform='translate(-16.8984375%2c -12)'%3e%3crect/%3e%3cforeignObject width='33.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eStart%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-B-1' data-look='classic' transform='translate(333.3984375%2c 139)'%3e%3crect class='basic label-container' style='' x='-89.5859375' y='-27' width='179.171875' height='54'/%3e%3cg class='label' style='' transform='translate(-59.5859375%2c -12)'%3e%3crect/%3e%3cforeignObject width='119.171875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eInitialize Counter%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-C-3' data-look='classic' transform='translate(333.3984375%2c 243)'%3e%3crect class='basic label-container' style='' x='-117.1796875' y='-27' width='234.359375' height='54'/%3e%3cg class='label' style='' transform='translate(-87.1796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='174.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEvaluate Loop Condition%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-G-5' data-look='classic' transform='translate(92.2578125%2c 371)'%3e%3crect class='basic label-container' style='' x='-84.2578125' y='-27' width='168.515625' height='54'/%3e%3cg class='label' style='' transform='translate(-54.2578125%2c -12)'%3e%3crect/%3e%3cforeignObject width='108.515625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eExit Loop / End%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-D-7' data-look='classic' transform='translate(333.3984375%2c 371)'%3e%3crect class='basic label-container' style='' x='-106.8828125' y='-27' width='213.765625' height='54'/%3e%3cg class='label' style='' transform='translate(-76.8828125%2c -12)'%3e%3crect/%3e%3cforeignObject width='153.765625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEvaluate 'If' Condition%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-E-9' data-look='classic' transform='translate(405.88671875%2c 499)'%3e%3crect class='basic label-container' style='' x='-90.4140625' y='-27' width='180.828125' height='54'/%3e%3cg class='label' style='' transform='translate(-60.4140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='120.828125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eExecute 'If' Block%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-2-flowchart-F-11' data-look='classic' transform='translate(404.33984375%2c 603)'%3e%3crect class='basic label-container' style='' x='-96.2578125' y='-27' width='192.515625' height='54'/%3e%3cg class='label' style='' transform='translate(-66.2578125%2c -12)'%3e%3crect/%3e%3cforeignObject width='132.515625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIncrement Counter%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-2-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-2-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
如圖所示,控制流圖完全忠實於程序的走向,它對於逆向人員來說也是非常寶貴的情報,有經驗的逆向人員可憑藉控制流圖在 3 秒鐘之內找到那個判斷激活碼是否正確的 if 分支。相反,如果沒了控制流圖,逆向人員想要推斷程序的意圖將會變得非常困難,因此在軟件保護的領域,如何對控制流圖進行混淆是一個非常值得探討的話題。
現在的問題是,控制流應該怎麼混淆呢?程序裏面有分支、循環和異常處理等基礎結構,我們總不可能把這些結構直接全部幹掉吧?這會破壞掉程序原有的功能。既然不能直接幹掉控制流,那開發者能做的就是掩蓋它,讓所有的基礎結構失去原有的特徵。一篇來自 2000 年的論文1首次提出了一種叫控制流拍平的靈感。
為了理解這種靈感,讓我們考慮下列程序。它非常簡單,全程順序執行,沒有分支和跳轉結構。我也把它的控制流圖畫在旁邊:
function calcPlus10(n: number) {
  console.log("開始計算 n + 10...");
  n = n + 1;
  n = n + 2;
  console.log("完成了一半力...");
  n = n + 3;
  n = n + 4;
  console.log("結果是 ", n);
  writeFileSync("./result.md", "結果是 " + n);
}%3btext-align:center%3b%7d%23mermaid-chart-3 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-3 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-3 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-3 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-3 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-3 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-3 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-3 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-3 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-3 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-3 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-3 .icon-shape%2c%23mermaid-chart-3 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-3 .icon-shape p%2c%23mermaid-chart-3 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-3 .icon-shape .label rect%2c%23mermaid-chart-3 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-3 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-3 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-3 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-3 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-3 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-3 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-3 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M85.57%2c62L85.57%2c66.167C85.57%2c70.333%2c85.57%2c78.667%2c85.57%2c86.333C85.57%2c94%2c85.57%2c101%2c85.57%2c104.5L85.57%2c108' id='mermaid-chart-3-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6ODUuNTcwMzEyNSwieSI6NjJ9LHsieCI6ODUuNTcwMzEyNSwieSI6ODd9LHsieCI6ODUuNTcwMzEyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M85.57%2c334L85.57%2c338.167C85.57%2c342.333%2c85.57%2c350.667%2c85.57%2c358.333C85.57%2c366%2c85.57%2c373%2c85.57%2c376.5L85.57%2c380' id='mermaid-chart-3-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6ODUuNTcwMzEyNSwieSI6MzM0fSx7IngiOjg1LjU3MDMxMjUsInkiOjM1OX0seyJ4Ijo4NS41NzAzMTI1LCJ5IjozODR9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-3-flowchart-B-0' data-look='classic' transform='translate(85.5703125%2c 223)'%3e%3crect class='basic label-container' style='' x='-77.5703125' y='-111' width='155.140625' height='222'/%3e%3cg class='label' style='' transform='translate(-47.5703125%2c -96)'%3e%3crect/%3e%3cforeignObject width='95.140625' height='192'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econsole.log%3cbr /%3e plus%3cbr /%3e plus%3cbr /%3e console.log%3cbr /%3e plus%3cbr /%3e plus%3cbr /%3e console.log%3cbr /%3e writeFileSync%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-3-flowchart-A-1' data-look='classic' transform='translate(85.5703125%2c 35)'%3e%3crect class='basic label-container' style='' x='-46.8984375' y='-27' width='93.796875' height='54'/%3e%3cg class='label' style='' transform='translate(-16.8984375%2c -12)'%3e%3crect/%3e%3cforeignObject width='33.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eStart%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-3-flowchart-C-4' data-look='classic' transform='translate(85.5703125%2c 411)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEnd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-3-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-3-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
我需要對代碼做出一些改變,才能讓這個無腦的控制流圖看上去更隱蔽一點。
首先進行代碼切割,把整個程序切分成多個 step,然後給每個 step 附加編號如下:
function calcPlus10(n: number) {
  let __step = 0;
  console.log("開始計算 n + 10...");
  n = n + 1;
  n = n + 2;
  __step = 1;
  console.log("完成了一半力...");
  n = n + 3;
  n = n + 4;
  __step = 2;
  console.log("結果是 ", n);
  writeFileSync("./result.md", "結果是 " + n);
  __step = 3;
}
現在每一個 step 都有了自己的編號,並且他們都知道自己下一步該進入哪個新 step。在上面的例子中,函數會從 step 0 開始運行,然後在 step 3 結束,於是現在我可以繼續改寫代碼,讓程序通過 switch case 自動前往對應編號的 step 塊:
function calcPlus10(n: number) {
  let __step = 0;
  while (__step !== 3) {
    switch (__step) {
      case 0:
        console.log("開始計算 n + 10...");
        n = n + 1; n = n + 2;
        __step = 1;
        break;
      case 1:
        console.log("完成了一半力...");
        n = n + 3; n = n + 4;
        __step = 2;
        break;
      case 2:
        console.log("結果是", n);
        writeFileSync("./result.md", "結果是 " + n)
        __step = 3;
        break;
    }
  }
}
控制流如圖:
%3btext-align:center%3b%7d%23mermaid-chart-4 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-4 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-4 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-4 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-4 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-4 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-4 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-4 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-4 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-4 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-4 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-4 .icon-shape%2c%23mermaid-chart-4 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-4 .icon-shape p%2c%23mermaid-chart-4 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-4 .icon-shape .label rect%2c%23mermaid-chart-4 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-4 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-4 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-4 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-4 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-4 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-4 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-4 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M467.477%2c62L467.477%2c66.167C467.477%2c70.333%2c467.477%2c78.667%2c467.477%2c86.333C467.477%2c94%2c467.477%2c101%2c467.477%2c104.5L467.477%2c108' id='mermaid-chart-4-L_start_sw_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_start_sw_0' data-points='W3sieCI6NDY3LjQ3NjU2MjUsInkiOjYyfSx7IngiOjQ2Ny40NzY1NjI1LCJ5Ijo4N30seyJ4Ijo0NjcuNDc2NTYyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M373.445%2c154.47L324.284%2c162.559C275.122%2c170.647%2c176.799%2c186.823%2c127.638%2c200.412C78.477%2c214%2c78.477%2c225%2c78.477%2c230.5L78.477%2c236' id='mermaid-chart-4-L_sw_c0_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c0_0' data-points='W3sieCI6MzczLjQ0NTMxMjUsInkiOjE1NC40NzA0MzcwMTc5OTQ4N30seyJ4Ijo3OC40NzY1NjI1LCJ5IjoyMDN9LHsieCI6NzguNDc2NTYyNSwieSI6MjQwfV0=' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M383.926%2c166L364.843%2c172.167C345.76%2c178.333%2c307.595%2c190.667%2c288.512%2c202.333C269.43%2c214%2c269.43%2c225%2c269.43%2c230.5L269.43%2c236' id='mermaid-chart-4-L_sw_c1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c1_0' data-points='W3sieCI6MzgzLjkyNTUzNzEwOTM3NSwieSI6MTY2fSx7IngiOjI2OS40Mjk2ODc1LCJ5IjoyMDN9LHsieCI6MjY5LjQyOTY4NzUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M467.477%2c166L467.477%2c172.167C467.477%2c178.333%2c467.477%2c190.667%2c467.477%2c204.333C467.477%2c218%2c467.477%2c233%2c467.477%2c240.5L467.477%2c248' id='mermaid-chart-4-L_sw_c2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c2_0' data-points='W3sieCI6NDY3LjQ3NjU2MjUsInkiOjE2Nn0seyJ4Ijo0NjcuNDc2NTYyNSwieSI6MjAzfSx7IngiOjQ2Ny40NzY1NjI1LCJ5IjoyNTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M542.204%2c166L559.272%2c172.167C576.339%2c178.333%2c610.474%2c190.667%2c627.542%2c208.333C644.609%2c226%2c644.609%2c249%2c644.609%2c260.5L644.609%2c272' id='mermaid-chart-4-L_sw_c3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c3_0' data-points='W3sieCI6NTQyLjIwNDQ2Nzc3MzQzNzUsInkiOjE2Nn0seyJ4Ijo2NDQuNjA5Mzc1LCJ5IjoyMDN9LHsieCI6NjQ0LjYwOTM3NSwieSI6Mjc2fV0=' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M78.477%2c366L78.477%2c370.167C78.477%2c374.333%2c78.477%2c382.667%2c113.369%2c393.09C148.261%2c403.514%2c218.044%2c416.028%2c252.936%2c422.285L287.828%2c428.542' id='mermaid-chart-4-L_c0_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c0_br_0' data-points='W3sieCI6NzguNDc2NTYyNSwieSI6MzY2fSx7IngiOjc4LjQ3NjU2MjUsInkiOjM5MX0seyJ4IjoyOTEuNzY1NjI1LCJ5Ijo0MjkuMjQ4MDI2NTEwNzYzM31d' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M269.43%2c366L269.43%2c370.167C269.43%2c374.333%2c269.43%2c382.667%2c276.774%2c390.69C284.118%2c398.713%2c298.807%2c406.427%2c306.151%2c410.284L313.496%2c414.14' id='mermaid-chart-4-L_c1_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c1_br_0' data-points='W3sieCI6MjY5LjQyOTY4NzUsInkiOjM2Nn0seyJ4IjoyNjkuNDI5Njg3NSwieSI6MzkxfSx7IngiOjMxNy4wMzcxMDkzNzUsInkiOjQxNn1d' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M467.477%2c354L467.477%2c360.167C467.477%2c366.333%2c467.477%2c378.667%2c460.132%2c388.69C452.788%2c398.713%2c438.099%2c406.427%2c430.755%2c410.284L423.411%2c414.14' id='mermaid-chart-4-L_c2_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c2_br_0' data-points='W3sieCI6NDY3LjQ3NjU2MjUsInkiOjM1NH0seyJ4Ijo0NjcuNDc2NTYyNSwieSI6MzkxfSx7IngiOjQxOS44NjkxNDA2MjUsInkiOjQxNn1d' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M445.141%2c432.39L495%2c425.492C544.859%2c418.593%2c644.578%2c404.797%2c694.438%2c383.232C744.297%2c361.667%2c744.297%2c332.333%2c744.297%2c301C744.297%2c269.667%2c744.297%2c236.333%2c714.482%2c212.773C684.666%2c189.214%2c625.036%2c175.427%2c595.22%2c168.534L565.405%2c161.641' id='mermaid-chart-4-L_br_sw_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_br_sw_0' data-points='W3sieCI6NDQ1LjE0MDYyNSwieSI6NDMyLjM4OTg3Mjc4NjIzMDk3fSx7IngiOjc0NC4yOTY4NzUsInkiOjM5MX0seyJ4Ijo3NDQuMjk2ODc1LCJ5IjozMDN9LHsieCI6NzQ0LjI5Njg3NSwieSI6MjAzfSx7IngiOjU2MS41MDc4MTI1LCJ5IjoxNjAuNzM5NzM0MTQ2MTM0OTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-4_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_start_sw_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(78.4765625%2c 203)'%3e%3cg class='label' data-id='L_sw_c0_0' transform='translate(-25.3515625%2c -12)'%3e%3cforeignObject width='50.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 0%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(269.4296875%2c 203)'%3e%3cg class='label' data-id='L_sw_c1_0' transform='translate(-25.3515625%2c -12)'%3e%3cforeignObject width='50.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(467.4765625%2c 203)'%3e%3cg class='label' data-id='L_sw_c2_0' transform='translate(-25.3515625%2c -12)'%3e%3cforeignObject width='50.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 2%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(644.609375%2c 203)'%3e%3cg class='label' data-id='L_sw_c3_0' transform='translate(-25.3515625%2c -12)'%3e%3cforeignObject width='50.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c0_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c1_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c2_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(744.296875%2c 303)'%3e%3cg class='label' data-id='L_br_sw_0' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eloop%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-4-flowchart-start-0' data-look='classic' transform='translate(467.4765625%2c 35)'%3e%3crect class='basic label-container' style='' x='-83.1328125' y='-27' width='166.265625' height='54'/%3e%3cg class='label' style='' transform='translate(-53.1328125%2c -12)'%3e%3crect/%3e%3cforeignObject width='106.265625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e(Start) step = 0%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-sw-1' data-look='classic' transform='translate(467.4765625%2c 139)'%3e%3crect class='basic label-container' style='' x='-94.03125' y='-27' width='188.0625' height='54'/%3e%3cg class='label' style='' transform='translate(-64.03125%2c -12)'%3e%3crect/%3e%3cforeignObject width='128.0625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eLoop Switch(step)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-c0-2' data-look='classic' transform='translate(78.4765625%2c 303)'%3e%3crect class='basic label-container' style='' x='-70.4765625' y='-63' width='140.953125' height='126'/%3e%3cg class='label' style='' transform='translate(-40.4765625%2c -48)'%3e%3crect/%3e%3cforeignObject width='80.953125' height='96'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econsole.log%3cbr /%3e plus%3cbr /%3e plus%3cbr /%3e step %f0%9f%91%89%f0%9f%8f%bb 1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-c1-3' data-look='classic' transform='translate(269.4296875%2c 303)'%3e%3crect class='basic label-container' style='' x='-70.4765625' y='-63' width='140.953125' height='126'/%3e%3cg class='label' style='' transform='translate(-40.4765625%2c -48)'%3e%3crect/%3e%3cforeignObject width='80.953125' height='96'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econsole.log%3cbr /%3e plus%3cbr /%3e plus%3cbr /%3e step %f0%9f%91%89%f0%9f%8f%bb 2%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-c2-4' data-look='classic' transform='translate(467.4765625%2c 303)'%3e%3crect class='basic label-container' style='' x='-77.5703125' y='-51' width='155.140625' height='102'/%3e%3cg class='label' style='' transform='translate(-47.5703125%2c -36)'%3e%3crect/%3e%3cforeignObject width='95.140625' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econsole.log%3cbr /%3e writeFileSync%3cbr /%3e step %f0%9f%91%89%f0%9f%8f%bb 3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-c3-5' data-look='classic' transform='translate(644.609375%2c 303)'%3e%3crect class='basic label-container' style='' x='-49.5625' y='-27' width='99.125' height='54'/%3e%3cg class='label' style='' transform='translate(-19.5625%2c -12)'%3e%3crect/%3e%3cforeignObject width='39.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e(End)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-4-flowchart-br-6' data-look='classic' transform='translate(368.453125%2c 443)'%3e%3crect class='basic label-container' style='' x='-76.6875' y='-27' width='153.375' height='54'/%3e%3cg class='label' style='' transform='translate(-46.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='93.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eBreak Switch%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-4-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-4-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
一通魔改之後控制流開始變得奇怪了起來,原本的執行順序消失了,取而代之的是一大堆 switch case,它會自動依據 step 的數值跳轉到對應的語句去執行。而且由於 step 的數值是前後銜接的,冥冥之中還保留了程序原本的運行邏輯。
我知道妳覺得這玩意很邪門,但還有更邪門的,讓我們再來看一個例子。假設原程序是這樣的:
function hello_world() {
  console.log("Hello...");
  if (getSystem() === "macOS") {
    console.log("...World!!");
  } else {
    fs.rmSync('C:\\Windows\\System32');
  }
  console.log("Good Luck!");
}%3btext-align:center%3b%7d%23mermaid-chart-5 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-5 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-5 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-5 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-5 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-5 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-5 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-5 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-5 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-5 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-5 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-5 .icon-shape%2c%23mermaid-chart-5 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-5 .icon-shape p%2c%23mermaid-chart-5 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-5 .icon-shape .label rect%2c%23mermaid-chart-5 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-5 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-5 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-5 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-5 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-5 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-5 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-5 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M169.129%2c62L169.129%2c66.167C169.129%2c70.333%2c169.129%2c78.667%2c169.129%2c86.333C169.129%2c94%2c169.129%2c101%2c169.129%2c104.5L169.129%2c108' id='mermaid-chart-5-L_hello_if_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_hello_if_0' data-points='W3sieCI6MTY5LjEyODkwNjI1LCJ5Ijo2Mn0seyJ4IjoxNjkuMTI4OTA2MjUsInkiOjg3fSx7IngiOjE2OS4xMjg5MDYyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M132.408%2c166L124.021%2c172.167C115.634%2c178.333%2c98.86%2c190.667%2c90.473%2c202.333C82.086%2c214%2c82.086%2c225%2c82.086%2c230.5L82.086%2c236' id='mermaid-chart-5-L_if_world_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_if_world_0' data-points='W3sieCI6MTMyLjQwNzY1MzgwODU5Mzc1LCJ5IjoxNjZ9LHsieCI6ODIuMDg1OTM3NSwieSI6MjAzfSx7IngiOjgyLjA4NTkzNzUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M205.85%2c166L214.237%2c172.167C222.624%2c178.333%2c239.398%2c190.667%2c247.785%2c202.333C256.172%2c214%2c256.172%2c225%2c256.172%2c230.5L256.172%2c236' id='mermaid-chart-5-L_if_rm_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_if_rm_0' data-points='W3sieCI6MjA1Ljg1MDE1ODY5MTQwNjI1LCJ5IjoxNjZ9LHsieCI6MjU2LjE3MTg3NSwieSI6MjAzfSx7IngiOjI1Ni4xNzE4NzUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M82.086%2c294L82.086%2c298.167C82.086%2c302.333%2c82.086%2c310.667%2c88.488%2c318.658C94.89%2c326.65%2c107.695%2c334.299%2c114.097%2c338.124L120.5%2c341.949' id='mermaid-chart-5-L_world_bye_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_world_bye_0' data-points='W3sieCI6ODIuMDg1OTM3NSwieSI6Mjk0fSx7IngiOjgyLjA4NTkzNzUsInkiOjMxOX0seyJ4IjoxMjMuOTMzNTE4NjI5ODA3NywieSI6MzQ0fV0=' data-look='classic' marker-end='url(%23mermaid-chart-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M256.172%2c294L256.172%2c298.167C256.172%2c302.333%2c256.172%2c310.667%2c249.77%2c318.658C243.367%2c326.65%2c230.563%2c334.299%2c224.16%2c338.124L217.758%2c341.949' id='mermaid-chart-5-L_rm_bye_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_rm_bye_0' data-points='W3sieCI6MjU2LjE3MTg3NSwieSI6Mjk0fSx7IngiOjI1Ni4xNzE4NzUsInkiOjMxOX0seyJ4IjoyMTQuMzI0MjkzODcwMTkyMzIsInkiOjM0NH1d' data-look='classic' marker-end='url(%23mermaid-chart-5_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_hello_if_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(82.0859375%2c 203)'%3e%3cg class='label' data-id='L_if_world_0' transform='translate(-12.453125%2c -12)'%3e%3cforeignObject width='24.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eyes%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(256.171875%2c 203)'%3e%3cg class='label' data-id='L_if_rm_0' transform='translate(-8.8984375%2c -12)'%3e%3cforeignObject width='17.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eno%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_world_bye_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_rm_bye_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-5-flowchart-hello-0' data-look='classic' transform='translate(169.12890625%2c 35)'%3e%3crect class='basic label-container' style='' x='-88.4609375' y='-27' width='176.921875' height='54'/%3e%3cg class='label' style='' transform='translate(-58.4609375%2c -12)'%3e%3crect/%3e%3cforeignObject width='116.921875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eStart: %f0%9f%92%ac Hello...%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-5-flowchart-if-1' data-look='classic' transform='translate(169.12890625%2c 139)'%3e%3crect class='basic label-container' style='' x='-102.90625' y='-27' width='205.8125' height='54'/%3e%3cg class='label' style='' transform='translate(-72.90625%2c -12)'%3e%3crect/%3e%3cforeignObject width='145.8125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eif system is macOS%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-5-flowchart-world-2' data-look='classic' transform='translate(82.0859375%2c 267)'%3e%3crect class='basic label-container' style='' x='-74.0859375' y='-27' width='148.171875' height='54'/%3e%3cg class='label' style='' transform='translate(-44.0859375%2c -12)'%3e%3crect/%3e%3cforeignObject width='88.171875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%92%ac ...World!!%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-5-flowchart-rm-3' data-look='classic' transform='translate(256.171875%2c 267)'%3e%3crect class='basic label-container' style='' x='-50' y='-27' width='100' height='54'/%3e%3cg class='label' style='' transform='translate(-20%2c -12)'%3e%3crect/%3e%3cforeignObject width='40' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%98%88%f0%9f%91%8d%f0%9f%8f%bb%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-5-flowchart-bye-4' data-look='classic' transform='translate(169.12890625%2c 371)'%3e%3crect class='basic label-container' style='' x='-101.8203125' y='-27' width='203.640625' height='54'/%3e%3cg class='label' style='' transform='translate(-71.8203125%2c -12)'%3e%3crect/%3e%3cforeignObject width='143.640625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEnd: %f0%9f%92%ac Good Luck!%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-5-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-5-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
像剛才一樣,我給這個程序分配 step 編號,不過這回使用隨機數:
function hello_world() {
  let __step = 114;
  console.log("Hello...");
  __step = 514;
  if (getSystem() === "macOS") {
    __step = 83;
    console.log("...World!!");
  } else {
    __step = 41;
    fs.rmSync('C:\\Windows\\System32');
  }
  __step = 1919;
  console.log("Good Luck!");
  __step = 810;
}
這個函數會從 114 開始執行,在 810 結束,於是我將代碼改寫為同樣的 switch case 狀態機,並且將 case 的排列順序打亂:
function hello_world() {
  let __step = 114;
  while (__step !== 810) {
    switch (__step) {
      case 41:
        fs.rmSync('C:\\Windows\\System32'); __step = 1919; break;
      case 514:
        if (getSystem() === "macOS") __step = 83; else __step = 41;
        break;
      case 1919:
        console.log("Good Luck!"); __step = 810; break;
      case 114:
        console.log("Hello..."); __step = 514; break;
      case 83:
        console.log("...World!!"); __step = 1919; break;
    }
  }
}
得到混淆後的控制流如下:
%3btext-align:center%3b%7d%23mermaid-chart-6 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-6 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-6 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-6 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-6 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-6 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-6 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-6 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-6 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-6 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-6 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-6 .icon-shape%2c%23mermaid-chart-6 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-6 .icon-shape p%2c%23mermaid-chart-6 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-6 .icon-shape .label rect%2c%23mermaid-chart-6 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-6 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-6 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-6 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-6 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-6 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-6 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-6 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-6_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-6_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M736.031%2c62L736.031%2c66.167C736.031%2c70.333%2c736.031%2c78.667%2c736.031%2c86.333C736.031%2c94%2c736.031%2c101%2c736.031%2c104.5L736.031%2c108' id='mermaid-chart-6-L_start_sw_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_start_sw_0' data-points='W3sieCI6NzM2LjAzMTI1LCJ5Ijo2Mn0seyJ4Ijo3MzYuMDMxMjUsInkiOjg3fSx7IngiOjczNi4wMzEyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M642%2c148.249L549.228%2c157.374C456.456%2c166.499%2c270.911%2c184.75%2c178.139%2c204.542C85.367%2c224.333%2c85.367%2c245.667%2c85.367%2c267C85.367%2c288.333%2c85.367%2c309.667%2c85.367%2c325.833C85.367%2c342%2c85.367%2c353%2c85.367%2c358.5L85.367%2c364' id='mermaid-chart-6-L_sw_c41_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c41_0' data-points='W3sieCI6NjQyLCJ5IjoxNDguMjQ5MDEyNDI3MjA3OH0seyJ4Ijo4NS4zNjcxODc1LCJ5IjoyMDN9LHsieCI6ODUuMzY3MTg3NSwieSI6MjY3fSx7IngiOjg1LjM2NzE4NzUsInkiOjMzMX0seyJ4Ijo4NS4zNjcxODc1LCJ5IjozNjh9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M642%2c159.395L608.492%2c166.662C574.984%2c173.93%2c507.969%2c188.465%2c474.461%2c201.232C440.953%2c214%2c440.953%2c225%2c440.953%2c230.5L440.953%2c236' id='mermaid-chart-6-L_sw_c514_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c514_0' data-points='W3sieCI6NjQyLCJ5IjoxNTkuMzk0NTk4ODg4MDA2MzZ9LHsieCI6NDQwLjk1MzEyNSwieSI6MjAzfSx7IngiOjQ0MC45NTMxMjUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M401.521%2c294L392.515%2c300.167C383.509%2c306.333%2c365.497%2c318.667%2c356.49%2c332.333C347.484%2c346%2c347.484%2c361%2c347.484%2c368.5L347.484%2c376' id='mermaid-chart-6-L_c514_c514y_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c514_c514y_0' data-points='W3sieCI6NDAxLjUyMDk5NjA5Mzc1LCJ5IjoyOTR9LHsieCI6MzQ3LjQ4NDM3NSwieSI6MzMxfSx7IngiOjM0Ny40ODQzNzUsInkiOjM4MH1d' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M480.385%2c294L489.391%2c300.167C498.397%2c306.333%2c516.41%2c318.667%2c525.416%2c332.333C534.422%2c346%2c534.422%2c361%2c534.422%2c368.5L534.422%2c376' id='mermaid-chart-6-L_c514_c514n_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c514_c514n_0' data-points='W3sieCI6NDgwLjM4NTI1MzkwNjI1LCJ5IjoyOTR9LHsieCI6NTM0LjQyMTg3NSwieSI6MzMxfSx7IngiOjUzNC40MjE4NzUsInkiOjM4MH1d' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M736.031%2c166L736.031%2c172.167C736.031%2c178.333%2c736.031%2c190.667%2c736.031%2c207.5C736.031%2c224.333%2c736.031%2c245.667%2c736.031%2c267C736.031%2c288.333%2c736.031%2c309.667%2c736.031%2c325.833C736.031%2c342%2c736.031%2c353%2c736.031%2c358.5L736.031%2c364' id='mermaid-chart-6-L_sw_c1919_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c1919_0' data-points='W3sieCI6NzM2LjAzMTI1LCJ5IjoxNjZ9LHsieCI6NzM2LjAzMTI1LCJ5IjoyMDN9LHsieCI6NzM2LjAzMTI1LCJ5IjoyNjd9LHsieCI6NzM2LjAzMTI1LCJ5IjozMzF9LHsieCI6NzM2LjAzMTI1LCJ5IjozNjh9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M642%2c150.221L568.289%2c159.018C494.578%2c167.814%2c347.156%2c185.407%2c273.445%2c199.704C199.734%2c214%2c199.734%2c225%2c199.734%2c230.5L199.734%2c236' id='mermaid-chart-6-L_sw_c810_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c810_0' data-points='W3sieCI6NjQyLCJ5IjoxNTAuMjIxMzk2NzMxMDU0OTd9LHsieCI6MTk5LjczNDM3NSwieSI6MjAzfSx7IngiOjE5OS43MzQzNzUsInkiOjI0MH1d' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M822.961%2c166L842.815%2c172.167C862.669%2c178.333%2c902.377%2c190.667%2c922.232%2c207.5C942.086%2c224.333%2c942.086%2c245.667%2c942.086%2c267C942.086%2c288.333%2c942.086%2c309.667%2c942.086%2c325.833C942.086%2c342%2c942.086%2c353%2c942.086%2c358.5L942.086%2c364' id='mermaid-chart-6-L_sw_c114_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c114_0' data-points='W3sieCI6ODIyLjk2MDU3MTI4OTA2MjUsInkiOjE2Nn0seyJ4Ijo5NDIuMDg1OTM3NSwieSI6MjAzfSx7IngiOjk0Mi4wODU5Mzc1LCJ5IjoyNjd9LHsieCI6OTQyLjA4NTkzNzUsInkiOjMzMX0seyJ4Ijo5NDIuMDg1OTM3NSwieSI6MzY4fV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M830.063%2c153.81L882.113%2c162.009C934.164%2c170.207%2c1038.266%2c186.603%2c1090.316%2c205.468C1142.367%2c224.333%2c1142.367%2c245.667%2c1142.367%2c267C1142.367%2c288.333%2c1142.367%2c309.667%2c1142.367%2c325.833C1142.367%2c342%2c1142.367%2c353%2c1142.367%2c358.5L1142.367%2c364' id='mermaid-chart-6-L_sw_c83_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_sw_c83_0' data-points='W3sieCI6ODMwLjA2MjUsInkiOjE1My44MTA0MDU0OTExNDYxfSx7IngiOjExNDIuMzY3MTg3NSwieSI6MjAzfSx7IngiOjExNDIuMzY3MTg3NSwieSI6MjY3fSx7IngiOjExNDIuMzY3MTg3NSwieSI6MzMxfSx7IngiOjExNDIuMzY3MTg3NSwieSI6MzY4fV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M85.367%2c446L85.367%2c450.167C85.367%2c454.333%2c85.367%2c462.667%2c180.365%2c474.425C275.364%2c486.184%2c465.36%2c501.368%2c560.358%2c508.961L655.356%2c516.553' id='mermaid-chart-6-L_c41_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c41_br_0' data-points='W3sieCI6ODUuMzY3MTg3NSwieSI6NDQ2fSx7IngiOjg1LjM2NzE4NzUsInkiOjQ3MX0seyJ4Ijo2NTkuMzQzNzUsInkiOjUxNi44NzEyNjEzMzE1NzIzfV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M347.484%2c434L347.484%2c440.167C347.484%2c446.333%2c347.484%2c458.667%2c398.8%2c471.701C450.116%2c484.735%2c552.748%2c498.471%2c604.063%2c505.338L655.379%2c512.206' id='mermaid-chart-6-L_c514y_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c514y_br_0' data-points='W3sieCI6MzQ3LjQ4NDM3NSwieSI6NDM0fSx7IngiOjM0Ny40ODQzNzUsInkiOjQ3MX0seyJ4Ijo2NTkuMzQzNzUsInkiOjUxMi43MzY3NTk1NjA4NjM4fV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M534.422%2c434L534.422%2c440.167C534.422%2c446.333%2c534.422%2c458.667%2c554.597%2c470.037C574.771%2c481.407%2c615.121%2c491.814%2c635.296%2c497.018L655.471%2c502.221' id='mermaid-chart-6-L_c514n_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c514n_br_0' data-points='W3sieCI6NTM0LjQyMTg3NSwieSI6NDM0fSx7IngiOjUzNC40MjE4NzUsInkiOjQ3MX0seyJ4Ijo2NTkuMzQzNzUsInkiOjUwMy4yMjA0MTM4NTcyNDI1fV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M736.031%2c446L736.031%2c450.167C736.031%2c454.333%2c736.031%2c462.667%2c736.031%2c470.333C736.031%2c478%2c736.031%2c485%2c736.031%2c488.5L736.031%2c492' id='mermaid-chart-6-L_c1919_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c1919_br_0' data-points='W3sieCI6NzM2LjAzMTI1LCJ5Ijo0NDZ9LHsieCI6NzM2LjAzMTI1LCJ5Ijo0NzF9LHsieCI6NzM2LjAzMTI1LCJ5Ijo0OTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M942.086%2c446L942.086%2c450.167C942.086%2c454.333%2c942.086%2c462.667%2c921.171%2c472.111C900.256%2c481.556%2c858.427%2c492.112%2c837.512%2c497.39L816.597%2c502.668' id='mermaid-chart-6-L_c114_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c114_br_0' data-points='W3sieCI6OTQyLjA4NTkzNzUsInkiOjQ0Nn0seyJ4Ijo5NDIuMDg1OTM3NSwieSI6NDcxfSx7IngiOjgxMi43MTg3NSwieSI6NTAzLjY0NzEyNzk2MjA4NTN9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M1142.367%2c446L1142.367%2c450.167C1142.367%2c454.333%2c1142.367%2c462.667%2c1088.087%2c473.78C1033.807%2c484.893%2c925.247%2c498.786%2c870.967%2c505.732L816.686%2c512.678' id='mermaid-chart-6-L_c83_br_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_c83_br_0' data-points='W3sieCI6MTE0Mi4zNjcxODc1LCJ5Ijo0NDZ9LHsieCI6MTE0Mi4zNjcxODc1LCJ5Ijo0NzF9LHsieCI6ODEyLjcxODc1LCJ5Ijo1MTMuMTg2MDc2MDIyMzc5OX1d' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M812.719%2c515.312L886.388%2c507.927C960.057%2c500.541%2c1107.396%2c485.771%2c1181.065%2c467.719C1254.734%2c449.667%2c1254.734%2c428.333%2c1254.734%2c405C1254.734%2c381.667%2c1254.734%2c356.333%2c1254.734%2c333C1254.734%2c309.667%2c1254.734%2c288.333%2c1254.734%2c267C1254.734%2c245.667%2c1254.734%2c224.333%2c1184.617%2c205.015C1114.5%2c185.697%2c974.266%2c168.395%2c904.149%2c159.743L834.032%2c151.092' id='mermaid-chart-6-L_br_sw_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_br_sw_0' data-points='W3sieCI6ODEyLjcxODc1LCJ5Ijo1MTUuMzEyMDc2MzkyNDQ1MX0seyJ4IjoxMjU0LjczNDM3NSwieSI6NDcxfSx7IngiOjEyNTQuNzM0Mzc1LCJ5Ijo0MDd9LHsieCI6MTI1NC43MzQzNzUsInkiOjMzMX0seyJ4IjoxMjU0LjczNDM3NSwieSI6MjY3fSx7IngiOjEyNTQuNzM0Mzc1LCJ5IjoyMDN9LHsieCI6ODMwLjA2MjUsInkiOjE1MC42MDIwMTIyMzAwMjA4fV0=' data-look='classic' marker-end='url(%23mermaid-chart-6_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_start_sw_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(85.3671875%2c 267)'%3e%3cg class='label' data-id='L_sw_c41_0' transform='translate(-29.8046875%2c -12)'%3e%3cforeignObject width='59.609375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 41%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(440.953125%2c 203)'%3e%3cg class='label' data-id='L_sw_c514_0' transform='translate(-34.25%2c -12)'%3e%3cforeignObject width='68.5' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 514%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(347.484375%2c 331)'%3e%3cg class='label' data-id='L_c514_c514y_0' transform='translate(-12.453125%2c -12)'%3e%3cforeignObject width='24.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eyes%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(534.421875%2c 331)'%3e%3cg class='label' data-id='L_c514_c514n_0' transform='translate(-8.8984375%2c -12)'%3e%3cforeignObject width='17.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eno%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(736.03125%2c 267)'%3e%3cg class='label' data-id='L_sw_c1919_0' transform='translate(-38.703125%2c -12)'%3e%3cforeignObject width='77.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 1919%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(199.734375%2c 203)'%3e%3cg class='label' data-id='L_sw_c810_0' transform='translate(-34.25%2c -12)'%3e%3cforeignObject width='68.5' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 810%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(942.0859375%2c 267)'%3e%3cg class='label' data-id='L_sw_c114_0' transform='translate(-33.65625%2c -12)'%3e%3cforeignObject width='67.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep: 114%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(1142.3671875%2c 267)'%3e%3cg class='label' data-id='L_sw_c83_0' transform='translate(-27.578125%2c -12)'%3e%3cforeignObject width='55.15625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eStep 83%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c41_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c514y_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c514n_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c1919_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c114_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_c83_br_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(1254.734375%2c 331)'%3e%3cg class='label' data-id='L_br_sw_0' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eloop%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-6-flowchart-start-0' data-look='classic' transform='translate(736.03125%2c 35)'%3e%3crect class='basic label-container' style='' x='-91.4375' y='-27' width='182.875' height='54'/%3e%3cg class='label' style='' transform='translate(-61.4375%2c -12)'%3e%3crect/%3e%3cforeignObject width='122.875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e(Start) step = 114%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-sw-1' data-look='classic' transform='translate(736.03125%2c 139)'%3e%3crect class='basic label-container' style='' x='-94.03125' y='-27' width='188.0625' height='54'/%3e%3cg class='label' style='' transform='translate(-64.03125%2c -12)'%3e%3crect/%3e%3cforeignObject width='128.0625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eLoop Switch(step)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c41-2' data-look='classic' transform='translate(85.3671875%2c 407)'%3e%3crect class='basic label-container' style='' x='-77.3671875' y='-39' width='154.734375' height='78'/%3e%3cg class='label' style='' transform='translate(-47.3671875%2c -24)'%3e%3crect/%3e%3cforeignObject width='94.734375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%98%88%f0%9f%91%8d%f0%9f%8f%bb%3cbr /%3e step %f0%9f%91%89%f0%9f%8f%bb 1919%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c514-3' data-look='classic' transform='translate(440.953125%2c 267)'%3e%3crect class='basic label-container' style='' x='-114.46875' y='-27' width='228.9375' height='54'/%3e%3cg class='label' style='' transform='translate(-84.46875%2c -12)'%3e%3crect/%3e%3cforeignObject width='168.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3egetSystem() is macOS%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c514y-4' data-look='classic' transform='translate(347.484375%2c 407)'%3e%3crect class='basic label-container' style='' x='-68.46875' y='-27' width='136.9375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.46875%2c -12)'%3e%3crect/%3e%3cforeignObject width='76.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3estep %f0%9f%91%89%f0%9f%8f%bb 83%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c514n-5' data-look='classic' transform='translate(534.421875%2c 407)'%3e%3crect class='basic label-container' style='' x='-68.46875' y='-27' width='136.9375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.46875%2c -12)'%3e%3crect/%3e%3cforeignObject width='76.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3estep %f0%9f%91%89%f0%9f%8f%bb 41%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c1919-6' data-look='classic' transform='translate(736.03125%2c 407)'%3e%3crect class='basic label-container' style='' x='-83.140625' y='-39' width='166.28125' height='78'/%3e%3cg class='label' style='' transform='translate(-53.140625%2c -24)'%3e%3crect/%3e%3cforeignObject width='106.28125' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%92%ac Good Luck!%3cbr /%3estep %f0%9f%91%89%f0%9f%8f%bb 810%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c810-7' data-look='classic' transform='translate(199.734375%2c 267)'%3e%3crect class='basic label-container' style='' x='-49.5625' y='-27' width='99.125' height='54'/%3e%3cg class='label' style='' transform='translate(-19.5625%2c -12)'%3e%3crect/%3e%3cforeignObject width='39.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e(End)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c114-8' data-look='classic' transform='translate(942.0859375%2c 407)'%3e%3crect class='basic label-container' style='' x='-72.9140625' y='-39' width='145.828125' height='78'/%3e%3cg class='label' style='' transform='translate(-42.9140625%2c -24)'%3e%3crect/%3e%3cforeignObject width='85.828125' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%92%ac Hello...%3cbr /%3estep %f0%9f%91%89%f0%9f%8f%bb 514%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-c83-9' data-look='classic' transform='translate(1142.3671875%2c 407)'%3e%3crect class='basic label-container' style='' x='-77.3671875' y='-39' width='154.734375' height='78'/%3e%3cg class='label' style='' transform='translate(-47.3671875%2c -24)'%3e%3crect/%3e%3cforeignObject width='94.734375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%f0%9f%92%ac ...World!!%3cbr /%3estep %f0%9f%91%89%f0%9f%8f%bb 1919%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-6-flowchart-br-10' data-look='classic' transform='translate(736.03125%2c 523)'%3e%3crect class='basic label-container' style='' x='-76.6875' y='-27' width='153.375' height='54'/%3e%3cg class='label' style='' transform='translate(-46.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='93.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eBreak Switch%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-6-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-6-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
妳應該注意到了,無論原本程序有多長、包含何種分支跳轉語句,一旦經過這些工序處理,控制流就被拍平成了一個橫向生長的、巨大的 switch case 循環。這個循環就像一個心臟一樣,不斷地將下一步要執行的動作送進 switch,而程序原有的邏輯就完全隱藏在了 step 的狀態變化之中。開發人員管這種混淆技術叫做「控制流拍平」,隨着代碼規模的增大,switch case 可以達到成百上千個,如果再繼續深入混淆,隱藏 step 變量讓其不要明文顯示,那要理解這個程序就會變得非常困難了。
開發人員多年來發展出了不同的控制流拍平方法,只是其底層思想始終未變:用一個不明顯的狀態變量偷偷取代所有的控制流程。當然,手撕上述拍平風味代碼是非常費事的,我需要一套自動化的方法來高效、準確地拍平需要混淆的程序。
2/ 編程語言的抽象語法樹
代碼混淆需要對代碼進行變形,而這個變形可不是亂變的,是要按照基本法的。混淆器需要保證變形後語法正確(廢話),語義正確,以及原有邏輯功能也正確。那麼有甚麼工具能如此正確地處理源代碼呢?
有的群友可能要說了:這個我董啊!寫宏 (macro) 啊!妳說得很對,宏可以在一定程度上實現代碼替換,就比如 C 語言那個臭名昭著的 #define,就是最純粹的文字替換,至於替換完以後 語法錯誤大大方方往裏進,就是最極致的 debug 享受了。
Rust 那邊也有一個更加高級的聲明式宏系統,叫 macro_rules!,這種宏不再是簡單的字符串替換,而是具備了感知語法的能力,可以辨別 token 的種類,包括字面量、表達式還有關鍵字啥的,創建的變量甚至還擁有自己的作用域,比 C 語言高到不知道哪裏去了。使用這種宏確實已經可以做出相當複雜的自動化代碼變形了。
然而,光能辨認 token 的種類,保證語法正確,生成文字列或者 token 列拼接,對於代碼混淆來說仍然不夠。我需要的是一種能批量、大規模地理解並重新生成程序語義和結構的能力,能符合這些要求的代碼處理系統,必須工作在抽象語法樹 (AST) 的層次上。
抽象語法樹 (AST) 是一種,抽象的,語法的,樹狀結構。光這麼說還是非常抽象,讓我直接上圖。下面是一段簡單的代碼和它的抽象語法樹:
if (getSystem() === "macOS") {
  console.log("Hello...");
  console.log("...World!!");
} else {
  fs.rmSync('C:\\Windows\\System32');
}
如圖所示,源代碼中的 if 語句的「判斷條件」「then 分支」「else 分支」都成為了 AST 上的節點。節點之間存在上下級包含關係,表示語法結構之間的嵌套關係。圖中很容易就能看出那句 console.log("Hello...") 就包含在 if 語句 -> then 分支 的 block { } 裏面。這個 AST 的實際數據結構 (JSON) 如下:
👉🏻 這玩意有 100 多行,點此展開
{
  "type": "File",
  "errors": [],
  "program": {
    "type": "Program",
    "sourceType": "script",
    "interpreter": null,
    "body": [
      {
        "type": "IfStatement",
        "test": {
          "type": "BinaryExpression",
          "left": {
            "type": "CallExpression",
            "callee": {
              "type": "Identifier",
              "name": "getSystem"
            },
            "arguments": []
          },
          "operator": "===",
          "right": {
            "type": "StringLiteral",
            "extra": {
              "rawValue": "macOS",
              "raw": "\"macOS\""
            },
            "value": "macOS"
          }
        },
        "consequent": {
          "type": "BlockStatement",
          "body": [
            {
              "type": "ExpressionStatement",
              "expression": {
                "type": "CallExpression",
                "callee": {
                  "type": "MemberExpression",
                  "object": {
                    "type": "Identifier",
                    "name": "console"
                  },
                  "computed": false,
                  "property": {
                    "type": "Identifier",
                    "name": "log"
                  }
                },
                "arguments": [
                  {
                    "type": "StringLiteral",
                    "extra": {
                      "rawValue": "Hello...",
                      "raw": "\"Hello...\""
                    },
                    "value": "Hello..."
                  }
                ]
              }
            },
            {
              "type": "ExpressionStatement",
              "expression": {
                "type": "CallExpression",
                "callee": {
                  "type": "MemberExpression",
                  "object": {
                    "type": "Identifier",
                    "name": "console"
                  },
                  "computed": false,
                  "property": {
                    "type": "Identifier",
                    "name": "log"
                  }
                },
                "arguments": [
                  {
                    "type": "StringLiteral",
                    "extra": {
                      "rawValue": "...World!!",
                      "raw": "\"...World!!\""
                    },
                    "value": "...World!!"
                  }
                ]
              }
            }
          ],
          "directives": []
        },
        "alternate": {
          "type": "BlockStatement",
          "body": [
            {
              "type": "ExpressionStatement",
              "expression": {
                "type": "CallExpression",
                "callee": {
                  "type": "MemberExpression",
                  "object": {
                    "type": "Identifier",
                    "name": "fs"
                  },
                  "computed": false,
                  "property": {
                    "type": "Identifier",
                    "name": "rmSync"
                  }
                },
                "arguments": [
                  {
                    "type": "StringLiteral",
                    "extra": {
                      "rawValue": "C:\\Windows\\System32",
                      "raw": "'C:\\\\Windows\\\\System32'"
                    },
                    "value": "C:\\Windows\\System32"
                  }
                ]
              }
            }
          ],
          "directives": []
        }
      }
    ],
    "directives": []
  },
  "comments": []
}
在 AST 上修改代碼是非常方便的,因為編譯器可以幫我檢查代碼並生成 AST,還能一鍵把 AST 轉換回源代碼。假設我要刪除掉上面的 else 分支,我就不需要去找甚麼「else 後面那個花括號在第幾行」了,而是直接在 AST 上砍掉整個 else 分支(就是上方 JSON 裏面那個 alternate)就完事了。
如果我要把 If 改成 While 也很簡單,只需要先把 If 底下那些 block 內容複製出來,然後把 IfStatement 換成 WhileStatement,再把原來那些 block 塞回去就行了。總而言之,有了 AST,代碼變形就從無腦的文字匹配替換變成了精準的「爬樹 - 摘果」操作,極大提高了效率和正確性。
現在再讓我們複習一下編譯器前端的工作流程:
%3btext-align:center%3b%7d%23mermaid-chart-7 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-7 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-7 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-chart-7 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-chart-7 .cluster text%7bfill:%23333%3b%7d%23mermaid-chart-7 .cluster span%7bcolor:%23333%3b%7d%23mermaid-chart-7 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-chart-7 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-chart-7 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-chart-7 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-chart-7 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-chart-7 .icon-shape%2c%23mermaid-chart-7 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-chart-7 .icon-shape p%2c%23mermaid-chart-7 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-chart-7 .icon-shape .label rect%2c%23mermaid-chart-7 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-7 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-7 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-7 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-7 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-7 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-7 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-7 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-chart-7_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-chart-7_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M475.43%2c47L475.43%2c51.167C475.43%2c55.333%2c475.43%2c63.667%2c475.43%2c71.333C475.43%2c79%2c475.43%2c86%2c475.43%2c89.5L475.43%2c93' id='mermaid-chart-7-e1' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e1' data-points='W3sieCI6NDc1LjQyOTY4NzUsInkiOjQ3fSx7IngiOjQ3NS40Mjk2ODc1LCJ5Ijo3Mn0seyJ4Ijo0NzUuNDI5Njg3NSwieSI6OTd9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M475.43%2c245L475.43%2c249.167C475.43%2c253.333%2c475.43%2c261.667%2c475.43%2c269.333C475.43%2c277%2c475.43%2c284%2c475.43%2c287.5L475.43%2c291' id='mermaid-chart-7-e2' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link edge-animation-fast' style='%3b' data-edge='true' data-et='edge' data-id='e2' data-points='W3sieCI6NDc1LjQyOTY4NzUsInkiOjI0NX0seyJ4Ijo0NzUuNDI5Njg3NSwieSI6MjcwfSx7IngiOjQ3NS40Mjk2ODc1LCJ5IjoyOTV9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-7_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e1' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='e2' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='root' transform='translate(0%2c 89)'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-chart-7-Frontend' data-look='classic'%3e%3crect style='' x='8' y='8' width='934.859375' height='148'/%3e%3cg class='cluster-label' transform='translate(318.1953125%2c 8)'%3e%3cforeignObject width='314.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%b7%a8%e8%ad%af%e5%99%a8%e5%89%8d%e7%ab%af (Analysis %26amp%3b Semantic Validation)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M212.219%2c82L218.469%2c82C224.719%2c82%2c237.219%2c82%2c249.052%2c82C260.885%2c82%2c272.052%2c82%2c277.635%2c82L283.219%2c82' id='mermaid-chart-7-L_LP_RawAST_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_LP_RawAST_0' data-points='W3sieCI6MjEyLjIxODc1LCJ5Ijo4Mn0seyJ4IjoyNDkuNzE4NzUsInkiOjgyfSx7IngiOjI4Ny4yMTg3NSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M413.906%2c82L420.156%2c82C426.406%2c82%2c438.906%2c82%2c450.74%2c82C462.573%2c82%2c473.74%2c82%2c479.323%2c82L484.906%2c82' id='mermaid-chart-7-L_RawAST_NRB_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_RawAST_NRB_0' data-points='W3sieCI6NDEzLjkwNjI1LCJ5Ijo4Mn0seyJ4Ijo0NTEuNDA2MjUsInkiOjgyfSx7IngiOjQ4OC45MDYyNSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M671.641%2c82L677.891%2c82C684.141%2c82%2c696.641%2c82%2c708.474%2c82C720.307%2c82%2c731.474%2c82%2c737.057%2c82L742.641%2c82' id='mermaid-chart-7-L_NRB_TC_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_NRB_TC_0' data-points='W3sieCI6NjcxLjY0MDYyNSwieSI6ODJ9LHsieCI6NzA5LjE0MDYyNSwieSI6ODJ9LHsieCI6NzQ2LjY0MDYyNSwieSI6ODJ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-7_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_LP_RawAST_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_RawAST_NRB_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_NRB_TC_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-7-flowchart-LP-1' data-look='classic' transform='translate(128.859375%2c 82)'%3e%3crect class='basic label-container' style='' x='-83.359375' y='-27' width='166.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-53.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='106.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eLexer %26amp%3b Parser%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-7-flowchart-RawAST-2' data-look='classic' transform='translate(350.5625%2c 82)'%3e%3crect class='basic label-container' style='' x='-63.34375' y='-27' width='126.6875' height='54'/%3e%3cg class='label' style='' transform='translate(-33.34375%2c -12)'%3e%3crect/%3e%3cforeignObject width='66.6875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRaw AST%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-7-flowchart-NRB-4' data-look='classic' transform='translate(580.2734375%2c 82)'%3e%3crect class='basic label-container' style='' x='-91.3671875' y='-39' width='182.734375' height='78'/%3e%3cg class='label' style='' transform='translate(-61.3671875%2c -24)'%3e%3crect/%3e%3cforeignObject width='122.734375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eName Resolution %3cbr /%3e Binding%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-7-flowchart-TC-6' data-look='classic' transform='translate(826%2c 82)'%3e%3crect class='basic label-container' style='' x='-79.359375' y='-27' width='158.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-49.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='98.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eType Checker%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-7-flowchart-Source-0' data-look='classic' transform='translate(475.4296875%2c 27.5)'%3e%3cpolygon points='-19.5%2c0 108.390625%2c0 127.890625%2c-39 0%2c-39' class='label-container' transform='translate(-54.1953125%2c19.5)'/%3e%3cg class='label' style='' transform='translate(-46.6953125%2c -12)'%3e%3crect/%3e%3cforeignObject width='93.390625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSource Code%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-7-flowchart-IR-7' data-look='classic' transform='translate(475.4296875%2c 334)'%3e%3crect class='basic label-container' style='' x='-130' y='-39' width='260' height='78'/%3e%3cg class='label' style='' transform='translate(-100%2c -24)'%3e%3crect/%3e%3cforeignObject width='200' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIntermediate Representation (IR)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-7-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-7-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
抽象語法樹是一個編譯中間產物,編譯器會在檢查源代碼語法正確以後生成 AST,因此 AST 蘊含了源代碼中的所有信息,卻又不像源代碼一樣多變易錯,方便了後續的編譯處理。至此,代碼混淆的大致思路就變成了:先用編譯器生成 AST,然後對 AST 做變形,最後再把 AST 轉換回源代碼,或者繼續完成編譯。
文章的後續將使用 JavaScript 完成代碼混淆的講解和演示。JS 生態裏面有一個非常成熟的編譯(轉譯)框架,叫 Babel。它提供了一整套庫函數來「爬樹」,能可靠地生成、編輯和處理 AST。下面是一個簡單的例子,用 Babel 來砍掉代碼中所有 if 語句的 else 分支:
traverse(ast, {  // 自動爬樹查找 if
  IfStatement(path) {
    path.node.alternate = null;
  },
});
去掉括號,整個步驟就三行,很快吧?要是以後誰還在用規則運算式查找「else 後面那個花括號在第幾行」,我會直接嘲笑她。
3/ 代碼預處理
知道了手撕拍平的做法,擁有了處理 AST 的工具,現在我似乎已經可以開始實現自動化代碼拍平的程序了。不過在這之前,JS 的 while true switch case 語法其實有一個巨大的坑需要解決,這個坑就是:
Case 裏面聲明過的變量會丟失 😇
假設現在有一個程序(左),拍平後變成了(右):
let a = "ciallo";
console.log(a);
let step = 0;
while(step !== 2) {
switch(step) {
case 0:
let a = "ciallo";
step = 1; break;
case 1:
console.log(a);
step = 2; break;
}
}執行拍平過的程序 console.log 會爆 ReferenceError: can’t access lexical declaration ‘a’ before initialization 的錯誤,說變量 a 未初始化。看上去 step 0 聲明的變量 a 作用域 (scope) 在第二次循環,也就是退出了 switch 語句塊的時候消失了。
再看另一個程序(左),拍平後變成了(右):
let a = "hello";
let a = "ciallo";
let step = 0;
while(step !== 2) {
switch(step) {
case 0:
let a = "hello";
step = 1; break;
case 1:
let a = "ciallo";
step = 2; break;
}
}其中,左邊的原程序是會報錯的,因為變量 a 不能重複聲明兩次;然而到了右邊,由於定義的變量會在一次循環之後消失,這個代碼反而能跑起來了 😅
這會引發 bug,我想讓變量的作用域和原程序一致,不說完全一致吧,但至少別憑空消失行嗎?所以我需要讓變量至少活過整個 while 或者整個函數。另外還有一些弔詭的程序,含有作用域塊和變量遮蔽 (shadowing),像這樣的:
let a = "hello";
{
  console.log(a);  // 必須要爆「變量未初始化」
  let a = "ciallo";
  console.log(a);  // 必須要是 ciallo
}
console.log(a);  // 必須要是 hello
要是拍平的時候不加處理,ciallo 就會把 hello 永久覆蓋掉,這也太壞了,最壞情況下會引發幹爛整個程序的 bug,「ciallo」必須得到有效解決。
JS 規定在退出作用域塊的時候,裏面聲明的變量必須全部消失,所以上面的內層 a 和外層 a 其實是完全不同的兩個變量,只是名字長得一樣而已。解決方法也很直白,既然它們是不同的變量,那就直接給它們安上不同的名字來消除歧義。我可以在 AST 上面掃描變量聲明,當發現聲明的變量和外層 scope 的變量出現了重名的時候,就給內層變量改個名字,確保它們拍平之後不再互相干擾,就像這樣:
let a = "hello";
{ // 在這個作用域裏面給 a 改名成 _a
  let _a = "ciallo";
  console.log(_a);  // 必須要是 ciallo
}
console.log(a);  // 必須要是 hello
Babel 裏面提供了一個 API 來查詢上層 scope 有沒有重名,還能自動生成重命名。保險起見,我決定強行更改一個函數中所有符號在不同作用域中的名字,做法是像這樣掃描 AST 進行改名:
functionNode.traverse({
  Scope(path) {
    if (path.isFunction()) {
      path.skip(); // own scope + subtree are handled by that function's pass
      return;
    }
    const scope = path.scope;
    for (const name of Object.keys(scope.bindings)) {
      // 把 scope 裏面定義的符號 全部拉清单
      scope.rename(name, scope.generateUid(name));
      // 然後批量改名
    }
  },
});
給變量改好名了再回去處理作用域報廢的問題。一個解決方法就是把所有變量聲明都移到 while 循環的外面,比如說(左)可以拍平成(右):
let a = "hello";
{
  let a = "ciallo";
}
var a, _a;
let step = 0;
while(step !== 2) {
switch(step) {
case 0:
a = "hello";
step = 1; break;
case 1:
_a = "ciallo";
step = 2; break;
}
}如此處理,從 case 裏面再訪問變量的時候,訪問到的就是一個全局可用的變量了,迴避了作用域消失的問題,同時上面的重命名系統也避免了名稱衝突的問題。看上去變量聲明的問題就這麼解決了 😇
關於變量聲明、變量訪問和變量遮蔽的問題,本章的內容只是冰山一角,並未完全覆蓋到編譯器定義、查找變量的過程,也沒涉及到把變量綁定到 closure 上的過程。對這些進階話題感興趣的群友,敬請移步 Crafting Interpreters 的 👉🏻第八章 和 👉🏻第十一章。
4/ 控制流拍平實現
安排好了變量的聲明,接下來就可以開始實現基於 AST 的代碼拍平了。在我查找相關資料的時候,發現了一篇 2007 年的論文2,作者首次在 C++ 上實現了控制流拍平的算法。然而他們的算法畫風是這樣的:
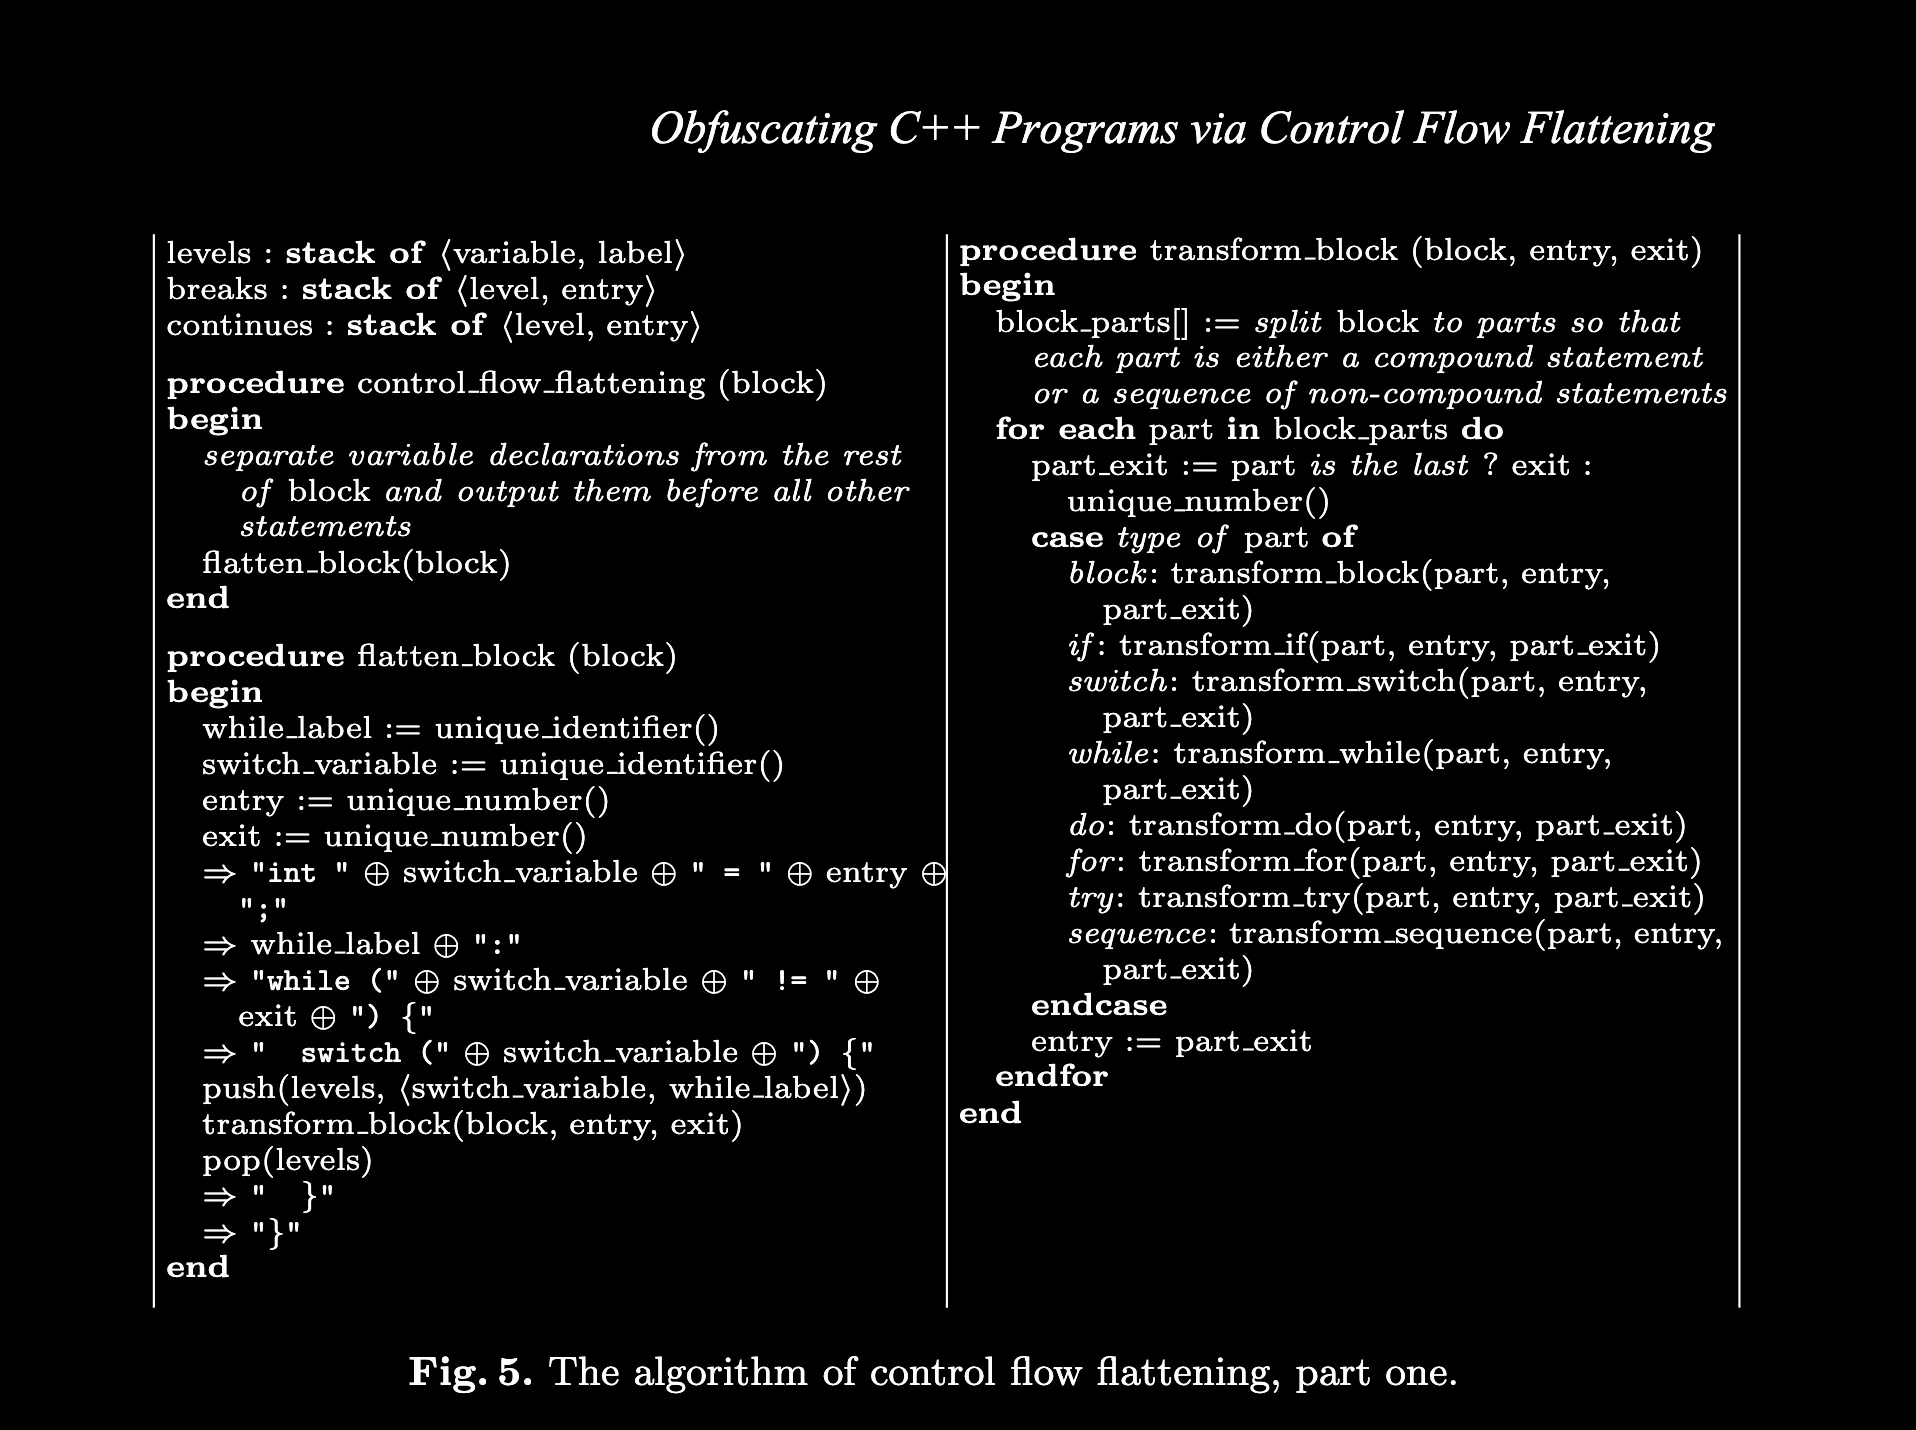
這可真的是……文文又本本,拼拼又接接啊 😇 從基於 AST 變形的現代做法來看,這篇論文中的做法無異於石器時代,不過其思路卻被後人沿用至今。
花了一點時間,我用 TypeScript 復刻了上面提到過的所有處理流程,包括:
實現的過程無聊得批爆,所以代碼我就不放了,感興趣的群友可以點上面的連結到我 GitHub 去看。不過值得一提的是,if 和 while 小塊並不是單純的鏈表節點,if 帶有一個判斷和兩個分支節點,分支節點跑完之後匯聚到下一個節點,如圖所示:
%3btext-align:center%3b%7d%23mermaid-chart-8 .edgeLabel%5bdata-look='neo'%5d p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-8 .edgeLabel%5bdata-look='neo'%5d rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-8 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-8 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-8 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-8 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-8 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-8 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-8 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-aggregationStart' class='marker aggregation classDiagram' refX='18' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-aggregationEnd' class='marker aggregation classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-aggregationStart-margin' class='marker aggregation classDiagram' refX='15' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 2%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-aggregationEnd-margin' class='marker aggregation classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 2%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-extensionStart' class='marker extension classDiagram' refX='18' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 1%2c7 L18%2c13 V 1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-extensionEnd' class='marker extension classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 1%2c1 V 13 L18%2c7 Z'/%3e%3c/marker%3e%3c/defs%3e%3cmarker id='mermaid-chart-8_classDiagram-extensionStart-margin' class='marker extension classDiagram' refX='18' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse' viewBox='0 0 20 14'%3e%3cpolygon points='10%2c7 18%2c13 18%2c1' style='stroke-width: 2%3b stroke-dasharray: 0%3b'/%3e%3c/marker%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-extensionEnd-margin' class='marker extension classDiagram' refX='9' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse' viewBox='0 0 20 14'%3e%3cpolygon points='10%2c1 10%2c13 18%2c7' style='stroke-width: 2%3b stroke-dasharray: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-compositionStart' class='marker composition classDiagram' refX='18' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-compositionEnd' class='marker composition classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-compositionStart-margin' class='marker composition classDiagram' refX='15' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath viewBox='0 0 15 15' d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-compositionEnd-margin' class='marker composition classDiagram' refX='3.5' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-dependencyStart' class='marker dependency classDiagram' refX='6' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 5%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-dependencyEnd' class='marker dependency classDiagram' refX='13' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-dependencyStart-margin' class='marker dependency classDiagram' refX='4' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 5%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-dependencyEnd-margin' class='marker dependency classDiagram' refX='16' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-lollipopStart' class='marker lollipop classDiagram' refX='13' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-lollipopEnd' class='marker lollipop classDiagram' refX='1' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-lollipopStart-margin' class='marker lollipop classDiagram' refX='13' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6' stroke-width='2'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-8_classDiagram-lollipopEnd-margin' class='marker lollipop classDiagram' refX='1' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6' stroke-width='2'/%3e%3c/marker%3e%3c/defs%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M111.617%2c238L118.305%2c238C124.992%2c238%2c138.367%2c238%2c150.742%2c238C163.117%2c238%2c174.492%2c238%2c180.18%2c238L185.867%2c238' id='mermaid-chart-8-id_Slice_IfSlice_1' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_Slice_IfSlice_1' data-points='W3sieCI6MTExLjYxNzE4NzUsInkiOjIzOH0seyJ4IjoxNTEuNzQyMTg3NSwieSI6MjM4fSx7IngiOjE5MS44NjcxODc1LCJ5IjoyMzh9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3cpath d='M339.5%2c174.33L360.046%2c156.608C380.591%2c138.886%2c421.682%2c103.443%2c462.07%2c85.722C502.458%2c68%2c542.143%2c68%2c561.986%2c68L581.828%2c68' id='mermaid-chart-8-id_IfSlice_TrueBranch_2' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_IfSlice_TrueBranch_2' data-points='W3sieCI6MzM5LjUsInkiOjE3NC4zMjk2MDA2MzQyMjg1fSx7IngiOjQ2Mi43NzM0Mzc1LCJ5Ijo2OH0seyJ4Ijo1ODcuODI4MTI1LCJ5Ijo2OH1d' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3cpath d='M339.5%2c238L360.046%2c238C380.591%2c238%2c421.682%2c238%2c461.773%2c238C501.865%2c238%2c540.956%2c238%2c560.501%2c238L580.047%2c238' id='mermaid-chart-8-id_IfSlice_FalseBranch_3' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_IfSlice_FalseBranch_3' data-points='W3sieCI6MzM5LjUsInkiOjIzOH0seyJ4Ijo0NjIuNzczNDM3NSwieSI6MjM4fSx7IngiOjU4Ni4wNDY4NzUsInkiOjIzOH1d' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3cpath d='M749.227%2c68L766.992%2c68C784.758%2c68%2c820.289%2c68%2c856.988%2c83.695C893.688%2c99.39%2c931.555%2c130.781%2c950.489%2c146.476L969.423%2c162.171' id='mermaid-chart-8-id_TrueBranch_IfMerge_4' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_TrueBranch_IfMerge_4' data-points='W3sieCI6NzQ5LjIyNjU2MjUsInkiOjY4fSx7IngiOjg1NS44MjAzMTI1LCJ5Ijo2OH0seyJ4Ijo5NzQuMDQxODE5ODUyOTQxMiwieSI6MTY2fV0=' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3cpath d='M751.008%2c238L768.477%2c238C785.945%2c238%2c820.883%2c238%2c854.82%2c238C888.758%2c238%2c921.695%2c238%2c938.164%2c238L954.633%2c238' id='mermaid-chart-8-id_FalseBranch_IfMerge_5' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_FalseBranch_IfMerge_5' data-points='W3sieCI6NzUxLjAwNzgxMjUsInkiOjIzOH0seyJ4Ijo4NTUuODIwMzEyNSwieSI6MjM4fSx7IngiOjk2MC42MzI4MTI1LCJ5IjoyMzh9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3cpath d='M339.5%2c278.075L360.046%2c289.229C380.591%2c300.383%2c421.682%2c322.692%2c476.52%2c333.846C531.358%2c345%2c599.943%2c345%2c665.451%2c345C730.958%2c345%2c793.389%2c345%2c841.187%2c336.348C888.985%2c327.696%2c922.149%2c310.393%2c938.731%2c301.741L955.313%2c293.089' id='mermaid-chart-8-id_IfSlice_IfMerge_6' class='edge-thickness-normal edge-pattern-dashed relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_IfSlice_IfMerge_6' data-points='W3sieCI6MzM5LjUsInkiOjI3OC4wNzQ4OTg0MjQzMzg1fSx7IngiOjQ2Mi43NzM0Mzc1LCJ5IjozNDV9LHsieCI6NjY4LjUyNzM0Mzc1LCJ5IjozNDV9LHsieCI6ODU1LjgyMDMxMjUsInkiOjM0NX0seyJ4Ijo5NjAuNjMyODEyNSwieSI6MjkwLjMxMzgyODU3MTQyODZ9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-8_classDiagram-dependencyEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel' transform='translate(151.7421875%2c 238)'%3e%3cg class='label' data-id='id_Slice_IfSlice_1' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enext%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(462.7734375%2c 68)'%3e%3cg class='label' data-id='id_IfSlice_TrueBranch_2' transform='translate(-91.75%2c -12)'%3e%3cforeignObject width='183.5' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enextTrue when test is true%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(462.7734375%2c 238)'%3e%3cg class='label' data-id='id_IfSlice_FalseBranch_3' transform='translate(-98.2734375%2c -12)'%3e%3cforeignObject width='196.546875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enextFalse when test is false%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(855.8203125%2c 68)'%3e%3cg class='label' data-id='id_TrueBranch_IfMerge_4' transform='translate(-79.8125%2c -12)'%3e%3cforeignObject width='159.625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3elast slice next = merge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(855.8203125%2c 238)'%3e%3cg class='label' data-id='id_FalseBranch_IfMerge_5' transform='translate(-79.8125%2c -12)'%3e%3cforeignObject width='159.625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3elast slice next = merge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(668.52734375%2c 345)'%3e%3cg class='label' data-id='id_IfSlice_IfMerge_6' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enext%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-8-classId-Slice-0' data-look='classic' transform='translate(59.80859375%2c 238)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-51.80859375 -72 L51.80859375 -72 L51.80859375 72 L-51.80859375 72' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-51.80859375 -72 C-23.123580820543786 -72%2c 5.5614321089124275 -72%2c 51.80859375 -72 M-51.80859375 -72 C-26.77973454564519 -72%2c -1.7508753412903815 -72%2c 51.80859375 -72 M51.80859375 -72 C51.80859375 -32.71294800500832%2c 51.80859375 6.574103989983357%2c 51.80859375 72 M51.80859375 -72 C51.80859375 -35.937224685451326%2c 51.80859375 0.12555062909734716%2c 51.80859375 72 M51.80859375 72 C27.639972220548206 72%2c 3.4713506910964114 72%2c -51.80859375 72 M51.80859375 72 C16.97617699829982 72%2c -17.85623975340036 72%2c -51.80859375 72 M-51.80859375 72 C-51.80859375 15.042485671827507%2c -51.80859375 -41.91502865634499%2c -51.80859375 -72 M-51.80859375 72 C-51.80859375 37.62518140889225%2c -51.80859375 3.250362817784506%2c -51.80859375 -72' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -48)'/%3e%3cg class='label-group text' transform='translate(-18.6796875%2c -48)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='37.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 85px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-39.80859375%2c 0)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='60.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 116px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint next%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-39.80859375%2c 72)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-51.80859375 -24 C-27.64682299066674 -23.999766816960175%2c -3.4850522313334835 -23.99953363392035%2c 51.80859375 -23.999 M-51.80859375 -24 C-18.290387813080393 -23.999676518859992%2c 15.227818123839214 -23.999353037719985%2c 51.80859375 -23.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-51.80859375 48 C-21.79763644146795 48.00028963300426%2c 8.213320867064098 48.000579266008515%2c 51.80859375 48.001 M-51.80859375 48 C-10.912804051055566 48.00039468152616%2c 29.982985647888867 48.00078936305232%2c 51.80859375 48.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-8-classId-IfSlice-1' data-look='classic' transform='translate(265.68359375%2c 238)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-73.81640625 -108 L73.81640625 -108 L73.81640625 108 L-73.81640625 108' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-73.81640625 -108 C-40.0105317421438 -108%2c -6.204657234287595 -108%2c 73.81640625 -108 M-73.81640625 -108 C-32.274948730470484 -108%2c 9.266508789059031 -108%2c 73.81640625 -108 M73.81640625 -108 C73.81640625 -64.02346190046335%2c 73.81640625 -20.04692380092669%2c 73.81640625 108 M73.81640625 -108 C73.81640625 -36.4396530999158%2c 73.81640625 35.1206938001684%2c 73.81640625 108 M73.81640625 108 C21.91887502338988 108%2c -29.97865620322024 108%2c -73.81640625 108 M73.81640625 108 C37.77028212603845 108%2c 1.724158002076905 108%2c -73.81640625 108 M-73.81640625 108 C-73.81640625 51.56559934205362%2c -73.81640625 -4.868801315892753%2c -73.81640625 -108 M-73.81640625 108 C-73.81640625 47.45331771989886%2c -73.81640625 -13.093364560202275%2c -73.81640625 -108' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -84)'/%3e%3cg class='label-group text' transform='translate(-23.5703125%2c -84)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='47.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 94px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eIfSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-61.81640625%2c -36)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='35.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 90px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2btest%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c36)'%3e%3cforeignObject width='93.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 148px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint nextTrue%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c60)'%3e%3cforeignObject width='100.0625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 155px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint nextFalse%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c84)'%3e%3cforeignObject width='76.046875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 131px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint merge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-61.81640625%2c 108)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-73.81640625 -60 C-30.765900793581913 -59.9997083947347%2c 12.284604662836173 -59.99941678946939%2c 73.81640625 -59.999 M-73.81640625 -60 C-35.185977299111244 -59.999738334396696%2c 3.444451651777513 -59.999476668793385%2c 73.81640625 -59.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-73.81640625 84 C-38.35821992943183 84.00024017822136%2c -2.900033608863666 84.00048035644272%2c 73.81640625 84.001 M-73.81640625 84 C-15.90199363540264 84.00039228686113%2c 42.01241897919472 84.00078457372226%2c 73.81640625 84.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-8-classId-TrueBranch-2' data-look='classic' transform='translate(668.52734375%2c 68)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-80.69921875 -60 L80.69921875 -60 L80.69921875 60 L-80.69921875 60' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-80.69921875 -60 C-48.381325354067826 -60%2c -16.063431958135652 -60%2c 80.69921875 -60 M-80.69921875 -60 C-28.646742202374952 -60%2c 23.405734345250096 -60%2c 80.69921875 -60 M80.69921875 -60 C80.69921875 -33.820958100355845%2c 80.69921875 -7.641916200711691%2c 80.69921875 60 M80.69921875 -60 C80.69921875 -13.449168613374468%2c 80.69921875 33.101662773251064%2c 80.69921875 60 M80.69921875 60 C27.195838086820665 60%2c -26.30754257635867 60%2c -80.69921875 60 M80.69921875 60 C18.095086878831758 60%2c -44.509044992336484 60%2c -80.69921875 60 M-80.69921875 60 C-80.69921875 23.877143651952352%2c -80.69921875 -12.245712696095296%2c -80.69921875 -60 M-80.69921875 60 C-80.69921875 26.39974966298452%2c -80.69921875 -7.2005006740309625%2c -80.69921875 -60' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -36)'/%3e%3cg class='label-group text' transform='translate(-44.4609375%2c -36)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='88.921875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 133px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eTrueBranch%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-68.69921875%2c 12)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='92.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 147px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bseq slices...%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-68.69921875%2c 60)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-80.69921875 -12 C-35.78404821644202 -11.999721712482295%2c 9.131122317115967 -11.999443424964587%2c 80.69921875 -11.999 M-80.69921875 -12 C-30.302840311032007 -11.999687751757579%2c 20.093538127935986 -11.999375503515157%2c 80.69921875 -11.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-80.69921875 36 C-24.972385472856722 36.00034527492422%2c 30.754447804286556 36.00069054984844%2c 80.69921875 36.001 M-80.69921875 36 C-34.26582057089077 36.00028769422367%2c 12.167577608218465 36.00057538844735%2c 80.69921875 36.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-8-classId-FalseBranch-3' data-look='classic' transform='translate(668.52734375%2c 238)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-82.48046875 -60 L82.48046875 -60 L82.48046875 60 L-82.48046875 60' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-82.48046875 -60 C-34.236151608865114 -60%2c 14.008165532269771 -60%2c 82.48046875 -60 M-82.48046875 -60 C-31.972886263300374 -60%2c 18.53469622339925 -60%2c 82.48046875 -60 M82.48046875 -60 C82.48046875 -12.517622552338544%2c 82.48046875 34.96475489532291%2c 82.48046875 60 M82.48046875 -60 C82.48046875 -22.658173349280517%2c 82.48046875 14.683653301438966%2c 82.48046875 60 M82.48046875 60 C19.88258347364505 60%2c -42.7153018027099 60%2c -82.48046875 60 M82.48046875 60 C38.53252798300585 60%2c -5.415412783988302 60%2c -82.48046875 60 M-82.48046875 60 C-82.48046875 34.12205393861635%2c -82.48046875 8.244107877232693%2c -82.48046875 -60 M-82.48046875 60 C-82.48046875 26.620418747682997%2c -82.48046875 -6.759162504634006%2c -82.48046875 -60' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -36)'/%3e%3cg class='label-group text' transform='translate(-48.0234375%2c -36)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='96.046875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 140px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eFalseBranch%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-70.48046875%2c 12)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='92.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 147px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bseq slices...%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-70.48046875%2c 60)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-82.48046875 -12 C-34.56880152936939 -11.999709557499207%2c 13.342865691261224 -11.999419114998414%2c 82.48046875 -11.999 M-82.48046875 -12 C-46.51013808573036 -11.99978194637343%2c -10.539807421460722 -11.99956389274686%2c 82.48046875 -11.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-82.48046875 36 C-24.918265530693787 36.000348944447644%2c 32.643937688612425 36.000697888895296%2c 82.48046875 36.001 M-82.48046875 36 C-39.761154073849376 36.000258966245724%2c 2.9581606023012483 36.000517932491455%2c 82.48046875 36.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-8-classId-IfMerge-4' data-look='classic' transform='translate(1060.8984375%2c 238)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-100.265625 -72 L100.265625 -72 L100.265625 72 L-100.265625 72' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-100.265625 -72 C-38.962834715290086 -72%2c 22.33995556941983 -72%2c 100.265625 -72 M-100.265625 -72 C-50.51372853446774 -72%2c -0.7618320689354761 -72%2c 100.265625 -72 M100.265625 -72 C100.265625 -26.533117841456352%2c 100.265625 18.933764317087295%2c 100.265625 72 M100.265625 -72 C100.265625 -42.687923123752725%2c 100.265625 -13.375846247505443%2c 100.265625 72 M100.265625 72 C52.960619862890816 72%2c 5.655614725781632 72%2c -100.265625 72 M100.265625 72 C31.376194189807094 72%2c -37.51323662038581 72%2c -100.265625 72 M-100.265625 72 C-100.265625 27.079370366761538%2c -100.265625 -17.841259266476925%2c -100.265625 -72 M-100.265625 72 C-100.265625 16.58359153726093%2c -100.265625 -38.83281692547814%2c -100.265625 -72' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -48)'/%3e%3cg class='label-group text' transform='translate(-28.453125%2c -48)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='56.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 104px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eIfMerge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-88.265625%2c 0)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='148.078125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 203px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bnext sibling or EXIT%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-88.265625%2c 72)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-100.265625 -24 C-38.53370935884153 -23.99969215812677%2c 23.198206282316946 -23.99938431625354%2c 100.265625 -23.999 M-100.265625 -24 C-50.18826367707435 -23.999750276521375%2c -0.1109023541487062 -23.99950055304275%2c 100.265625 -23.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-100.265625 48 C-41.1320637433164 48.00029488451928%2c 18.001497513367198 48.000589769038555%2c 100.265625 48.001 M-100.265625 48 C-23.904784401404257 48.000380792722325%2c 52.45605619719149 48.00076158544465%2c 100.265625 48.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-8-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-8-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
While 也帶有一個判斷和一個循環節點,循環結束後才會跳到下一個後繼節點:
%3btext-align:center%3b%7d%23mermaid-chart-9 .edgeLabel%5bdata-look='neo'%5d p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-9 .edgeLabel%5bdata-look='neo'%5d rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-chart-9 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-chart-9 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-chart-9 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node rect%2c%23mermaid-chart-9 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-chart-9 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-9 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-chart-9 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-aggregationStart' class='marker aggregation classDiagram' refX='18' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-aggregationEnd' class='marker aggregation classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-aggregationStart-margin' class='marker aggregation classDiagram' refX='15' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 2%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-aggregationEnd-margin' class='marker aggregation classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 2%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-extensionStart' class='marker extension classDiagram' refX='18' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 1%2c7 L18%2c13 V 1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-extensionEnd' class='marker extension classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 1%2c1 V 13 L18%2c7 Z'/%3e%3c/marker%3e%3c/defs%3e%3cmarker id='mermaid-chart-9_classDiagram-extensionStart-margin' class='marker extension classDiagram' refX='18' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse' viewBox='0 0 20 14'%3e%3cpolygon points='10%2c7 18%2c13 18%2c1' style='stroke-width: 2%3b stroke-dasharray: 0%3b'/%3e%3c/marker%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-extensionEnd-margin' class='marker extension classDiagram' refX='9' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse' viewBox='0 0 20 14'%3e%3cpolygon points='10%2c1 10%2c13 18%2c7' style='stroke-width: 2%3b stroke-dasharray: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-compositionStart' class='marker composition classDiagram' refX='18' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-compositionEnd' class='marker composition classDiagram' refX='1' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-compositionStart-margin' class='marker composition classDiagram' refX='15' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath viewBox='0 0 15 15' d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-compositionEnd-margin' class='marker composition classDiagram' refX='3.5' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-dependencyStart' class='marker dependency classDiagram' refX='6' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 5%2c7 L9%2c13 L1%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-dependencyEnd' class='marker dependency classDiagram' refX='13' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-dependencyStart-margin' class='marker dependency classDiagram' refX='4' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 5%2c7 L9%2c13 L1%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-dependencyEnd-margin' class='marker dependency classDiagram' refX='16' refY='7' markerWidth='20' markerHeight='28' orient='auto' markerUnits='userSpaceOnUse'%3e%3cpath d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z' style='stroke-width: 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-lollipopStart' class='marker lollipop classDiagram' refX='13' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-lollipopEnd' class='marker lollipop classDiagram' refX='1' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-lollipopStart-margin' class='marker lollipop classDiagram' refX='13' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6' stroke-width='2'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-chart-9_classDiagram-lollipopEnd-margin' class='marker lollipop classDiagram' refX='1' refY='7' markerWidth='190' markerHeight='240' orient='auto' markerUnits='userSpaceOnUse'%3e%3ccircle fill='transparent' cx='7' cy='7' r='6' stroke-width='2'/%3e%3c/marker%3e%3c/defs%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M111.617%2c143L118.305%2c143C124.992%2c143%2c138.367%2c143%2c150.742%2c143C163.117%2c143%2c174.492%2c143%2c180.18%2c143L185.867%2c143' id='mermaid-chart-9-id_Slice_WhileSlice_1' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_Slice_WhileSlice_1' data-points='W3sieCI6MTExLjYxNzE4NzUsInkiOjE0M30seyJ4IjoxNTEuNzQyMTg3NSwieSI6MTQzfSx7IngiOjE5MS44NjcxODc1LCJ5IjoxNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-9_classDiagram-dependencyEnd)'/%3e%3cpath d='M353.289%2c106.192L373.094%2c97.16C392.898%2c88.128%2c432.508%2c70.064%2c475.493%2c62.664C518.478%2c55.263%2c564.838%2c58.526%2c588.018%2c60.158L611.198%2c61.789' id='mermaid-chart-9-id_WhileSlice_BodyBranch_2' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_WhileSlice_BodyBranch_2' data-points='W3sieCI6MzUzLjI4OTA2MjUsInkiOjEwNi4xOTE2OTE3ODk2NzE1MX0seyJ4Ijo0NzIuMTE3MTg3NSwieSI6NTJ9LHsieCI6NjE3LjE4MzU5Mzc1LCJ5Ijo2Mi4yMTA3MTI2Mjg2NjY2OH1d' data-look='classic' marker-end='url(%23mermaid-chart-9_classDiagram-dependencyEnd)'/%3e%3cpath d='M617.184%2c95.137L593.006%2c103.114C568.828%2c111.092%2c520.473%2c127.046%2c477.49%2c135.023C434.508%2c143%2c396.898%2c143%2c378.094%2c143L359.289%2c143' id='mermaid-chart-9-id_BodyBranch_WhileSlice_3' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_BodyBranch_WhileSlice_3' data-points='W3sieCI6NjE3LjE4MzU5Mzc1LCJ5Ijo5NS4xMzcyODQ1NTMxMjQ5NH0seyJ4Ijo0NzIuMTE3MTg3NSwieSI6MTQzfSx7IngiOjM1My4yODkwNjI1LCJ5IjoxNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-9_classDiagram-dependencyEnd)'/%3e%3cpath d='M353.289%2c186.28L373.094%2c196.9C392.898%2c207.52%2c432.508%2c228.76%2c471.117%2c239.38C509.727%2c250%2c547.336%2c250%2c566.141%2c250L584.945%2c250' id='mermaid-chart-9-id_WhileSlice_WhileMerge_4' class='edge-thickness-normal edge-pattern-solid relation' style='%3b%3b%3b' data-edge='true' data-et='edge' data-id='id_WhileSlice_WhileMerge_4' data-points='W3sieCI6MzUzLjI4OTA2MjUsInkiOjE4Ni4yODAwOTg2NjQ4OTE3NH0seyJ4Ijo0NzIuMTE3MTg3NSwieSI6MjUwfSx7IngiOjU5MC45NDUzMTI1LCJ5IjoyNTB9XQ==' data-look='classic' marker-end='url(%23mermaid-chart-9_classDiagram-dependencyEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel' transform='translate(151.7421875%2c 143)'%3e%3cg class='label' data-id='id_Slice_WhileSlice_1' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enext%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(479.51059%2c 52.5204)'%3e%3cg class='label' data-id='id_WhileSlice_BodyBranch_2' transform='translate(-93.828125%2c -12)'%3e%3cforeignObject width='187.65625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enextBody when test is true%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='id_BodyBranch_WhileSlice_3' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(472.1171875%2c 250)'%3e%3cg class='label' data-id='id_WhileSlice_WhileMerge_4' transform='translate(-15.125%2c -12)'%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3enext%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-chart-9-classId-Slice-5' data-look='classic' transform='translate(59.80859375%2c 143)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-51.80859375 -72 L51.80859375 -72 L51.80859375 72 L-51.80859375 72' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-51.80859375 -72 C-10.949348658134326 -72%2c 29.909896433731348 -72%2c 51.80859375 -72 M-51.80859375 -72 C-29.750344411234636 -72%2c -7.692095072469272 -72%2c 51.80859375 -72 M51.80859375 -72 C51.80859375 -26.181079631068798%2c 51.80859375 19.637840737862405%2c 51.80859375 72 M51.80859375 -72 C51.80859375 -36.96267932444837%2c 51.80859375 -1.925358648896733%2c 51.80859375 72 M51.80859375 72 C12.008960202778347 72%2c -27.790673344443306 72%2c -51.80859375 72 M51.80859375 72 C30.902736835572824 72%2c 9.996879921145648 72%2c -51.80859375 72 M-51.80859375 72 C-51.80859375 40.72737510674193%2c -51.80859375 9.454750213483862%2c -51.80859375 -72 M-51.80859375 72 C-51.80859375 23.639333197498672%2c -51.80859375 -24.721333605002656%2c -51.80859375 -72' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -48)'/%3e%3cg class='label-group text' transform='translate(-18.6796875%2c -48)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='37.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 85px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-39.80859375%2c 0)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='60.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 116px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint next%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-39.80859375%2c 72)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-51.80859375 -24 C-17.70084645395699 -23.999670829250253%2c 16.406900842086017 -23.999341658500505%2c 51.80859375 -23.999 M-51.80859375 -24 C-10.514989614009366 -23.99960147920309%2c 30.778614521981268 -23.99920295840618%2c 51.80859375 -23.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-51.80859375 48 C-21.090610952292618 48.00029645644259%2c 9.627371845414764 48.00059291288518%2c 51.80859375 48.001 M-51.80859375 48 C-15.914651450836793 48.00034640915436%2c 19.979290848326414 48.00069281830872%2c 51.80859375 48.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-9-classId-WhileSlice-6' data-look='classic' transform='translate(272.578125%2c 143)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-80.7109375 -96 L80.7109375 -96 L80.7109375 96 L-80.7109375 96' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-80.7109375 -96 C-20.109355240849013 -96%2c 40.492227018301975 -96%2c 80.7109375 -96 M-80.7109375 -96 C-35.36431444885235 -96%2c 9.982308602295305 -96%2c 80.7109375 -96 M80.7109375 -96 C80.7109375 -31.813101970057943%2c 80.7109375 32.373796059884114%2c 80.7109375 96 M80.7109375 -96 C80.7109375 -56.256418672829646%2c 80.7109375 -16.512837345659293%2c 80.7109375 96 M80.7109375 96 C42.448222944383936 96%2c 4.185508388767872 96%2c -80.7109375 96 M80.7109375 96 C40.14356563963924 96%2c -0.4238062207215165 96%2c -80.7109375 96 M-80.7109375 96 C-80.7109375 29.032643350239553%2c -80.7109375 -37.934713299520894%2c -80.7109375 -96 M-80.7109375 96 C-80.7109375 45.631881116666065%2c -80.7109375 -4.73623776666787%2c -80.7109375 -96' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -72)'/%3e%3cg class='label-group text' transform='translate(-40.015625%2c -72)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='80.03125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 125px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eWhileSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-68.7109375%2c -24)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='35.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 90px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2btest%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c36)'%3e%3cforeignObject width='97.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 152px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint nextBody%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c60)'%3e%3cforeignObject width='76.046875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 131px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint merge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-68.7109375%2c 96)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-80.7109375 -48 C-30.662400983464558 -47.99968995195653%2c 19.386135533070885 -47.999379903913066%2c 80.7109375 -47.999 M-80.7109375 -48 C-37.651750659108885 -47.99973325060906%2c 5.407436181782231 -47.999466501218116%2c 80.7109375 -47.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-80.7109375 72 C-44.35879733731812 72.00022519959059%2c -8.006657174636246 72.00045039918119%2c 80.7109375 72.001 M-80.7109375 72 C-37.730734597064334 72.00026626008962%2c 5.249468305871332 72.00053252017923%2c 80.7109375 72.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-9-classId-BodyBranch-7' data-look='classic' transform='translate(699.43359375%2c 68)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-82.25 -60 L82.25 -60 L82.25 60 L-82.25 60' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-82.25 -60 C-43.189081690475376 -60%2c -4.1281633809507525 -60%2c 82.25 -60 M-82.25 -60 C-26.2301176699997 -60%2c 29.7897646600006 -60%2c 82.25 -60 M82.25 -60 C82.25 -25.5247872796373%2c 82.25 8.950425440725397%2c 82.25 60 M82.25 -60 C82.25 -31.20085134772149%2c 82.25 -2.401702695442978%2c 82.25 60 M82.25 60 C48.13479337208623 60%2c 14.019586744172457 60%2c -82.25 60 M82.25 60 C39.70363411569042 60%2c -2.84273176861916 60%2c -82.25 60 M-82.25 60 C-82.25 31.216302008626748%2c -82.25 2.432604017253496%2c -82.25 -60 M-82.25 60 C-82.25 15.641389918804421%2c -82.25 -28.717220162391158%2c -82.25 -60' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -36)'/%3e%3cg class='label-group text' transform='translate(-47.5625%2c -36)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='95.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 137px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eBodyBranch%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-70.25%2c 12)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='92.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 147px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bseq slices...%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-70.25%2c 60)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-82.25 -12 C-34.95852206239968 -11.99971251381193%2c 12.33295587520064 -11.99942502762386%2c 82.25 -11.999 M-82.25 -12 C-43.20089540136833 -11.999762619424933%2c -4.151790802736656 -11.999525238849865%2c 82.25 -11.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-82.25 36 C-34.53042809436226 36.000290088583014%2c 13.189143811275486 36.00058017716602%2c 82.25 36.001 M-82.25 36 C-35.92297403282219 36.00028162325816%2c 10.404051934355621 36.000563246516315%2c 82.25 36.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-chart-9-classId-WhileMerge-8' data-look='classic' transform='translate(699.43359375%2c 250)'%3e%3cg class='basic label-container outer-path'%3e%3cpath d='M-108.48828125 -72 L108.48828125 -72 L108.48828125 72 L-108.48828125 72' stroke='none' stroke-width='0' fill='%23ECECFF' style=''/%3e%3cpath d='M-108.48828125 -72 C-59.82869569222529 -72%2c -11.169110134450577 -72%2c 108.48828125 -72 M-108.48828125 -72 C-34.43656140514585 -72%2c 39.615158439708296 -72%2c 108.48828125 -72 M108.48828125 -72 C108.48828125 -23.982928153172935%2c 108.48828125 24.03414369365413%2c 108.48828125 72 M108.48828125 -72 C108.48828125 -39.23746146686405%2c 108.48828125 -6.474922933728095%2c 108.48828125 72 M108.48828125 72 C32.733869843880285 72%2c -43.02054156223943 72%2c -108.48828125 72 M108.48828125 72 C31.632552362209694 72%2c -45.22317652558061 72%2c -108.48828125 72 M-108.48828125 72 C-108.48828125 43.174127818169126%2c -108.48828125 14.348255636338251%2c -108.48828125 -72 M-108.48828125 72 C-108.48828125 35.08552304765026%2c -108.48828125 -1.8289539046994747%2c -108.48828125 -72' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='annotation-group text' transform='translate(0%2c -48)'/%3e%3cg class='label-group text' transform='translate(-44.8984375%2c -48)'%3e%3cg class='label' style='font-weight: bolder' transform='translate(0%2c-12)'%3e%3cforeignObject width='89.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 135px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3eWhileMerge%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='members-group text' transform='translate(-96.48828125%2c 0)'%3e%3cg class='label' style='' transform='translate(0%2c-12)'%3e%3cforeignObject width='43.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 98px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bint id%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3cg class='label' style='' transform='translate(0%2c12)'%3e%3cforeignObject width='148.078125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 203px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label' style=''%3e%3cp%3e%2bnext sibling or EXIT%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='methods-group text' transform='translate(-96.48828125%2c 72)'/%3e%3cg class='divider' style=''%3e%3cpath d='M-108.48828125 -24 C-43.99101362910511 -23.999702745463022%2c 20.506253991789777 -23.999405490926044%2c 108.48828125 -23.999 M-108.48828125 -24 C-56.20149898267773 -23.999759021058935%2c -3.9147167153554534 -23.999518042117867%2c 108.48828125 -23.999' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3cg class='divider' style=''%3e%3cpath d='M-108.48828125 48 C-23.871332818999306 48.00038998197527%2c 60.74561561200139 48.000779963950535%2c 108.48828125 48.001 M-108.48828125 48 C-53.59209338297874 48.000253005150576%2c 1.3040944840425226 48.00050601030115%2c 108.48828125 48.001' stroke='%239370DB' stroke-width='1.3' fill='none' stroke-dasharray='0 0' style=''/%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-chart-9-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-chart-9-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
當每個小塊都分配到了自己的 id,以及得知下一個節點的 id 之後,這些小塊就會被轉換成 switch 語句裏面的一個 case。每個小塊會在恰當的時候執行,執行完畢後再將下一個小塊的 id 賦予到 step,就像接力一樣,把控制權這根棒子交到下一個小塊的手裏。
至此我已經拍平了普通語句、if 和 while 語句,但是 for 循環和 try catch 語句還沒支持。這些沒支持的語句拍不扁,會被整個塞到一個 case 裏面,失去混淆的效果。雖然我這只是一個學習版項目,但是為了提升實用性,我覺得至少應該支持一下最基礎的 for 循環。
for 循環有個特點,他可以在循環的頭部聲明變量,下面這個循環中的變量 i 就只在循環之中存在:
for (let i = 0; i < 10; i++) {
  sum = sum + i;
}
這些變量如果處理不得當容易導致定義域方面的 bug。一個懶狗的解決方法就是把 for 循環寫成 while,並用一個花括號塊來限制定義域,於是上面那個循環可以改寫成:
{
  let i = 0;
  while (i < 10) {
    sum = sum + i;
    i++;
  }
}
之後就可以按照拍扁 while 循環的方法來進行混淆了,懶狗到家,輕鬆實現,接下來通過一點簡單的 AST 變形完成 for 循環的改寫……但是問題是,萬一 for 裏面有 continue 怎麼辦?他會跳過最後一行的 i++ 導致無限循環。Ok 懶狗做法帥不過 3 秒,還是讓我老實手撕跳轉分支吧 😇
那個 i++ 的部分必須放在獨立的小塊裏面,非常麻煩。經過一通爆改 (👉🏻代碼) 之後,我成功把 for 循環進行了拍平:
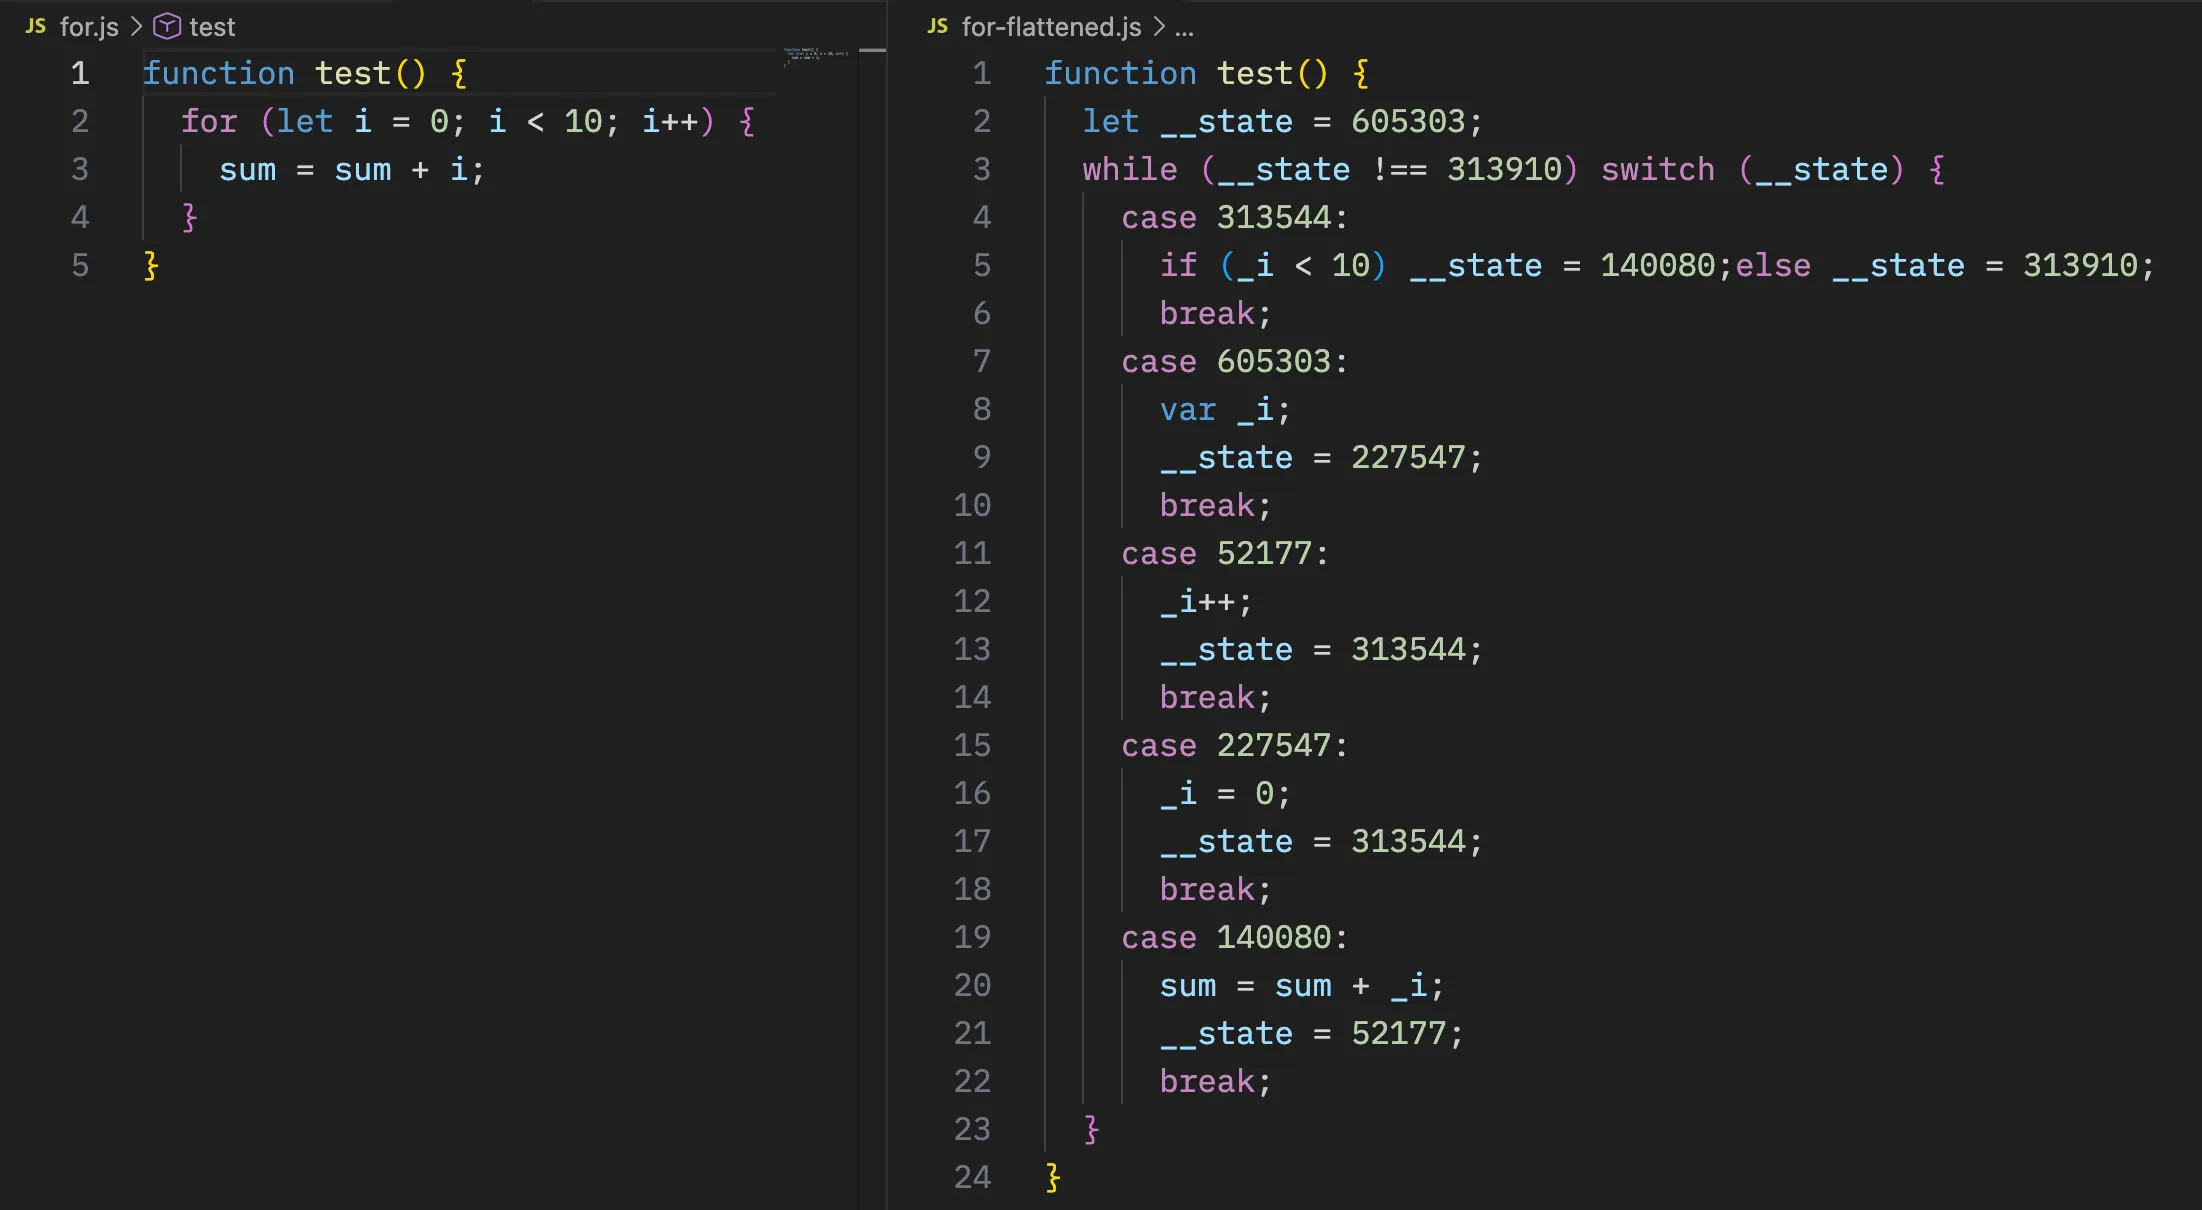
一個簡單的 for 循環被混淆得面目全非,我對自己的代碼感到非常滿意!😁
接下來可以進入喜聞樂見的跑分環節了!
5/ 性能測試
JavaScript 的 V8 執行引擎非常先進,其內置的 JIT 編譯器能夠優化出速度堪比 C 語言的機器碼。特別是對於循環的部分,JIT 能夠直接認出變量 i 是循環的索引,然後將它固定在 CPU 的寄存器裏面!這樣每一個循環跳轉只需要執行兩條甚至是一條指令,從而獲得極大的性能提升。
有位群友發表了一篇用 Python 算質數的 blog,對於基於 bytearray 的埃拉托色尼篩法,計算 1 億以下的質數需要 2.57 秒。那我自然是不能放任 Python 囂張的,於是帶着 Node.js 去砸場,在同樣的算法下跑出了 3.5 倍的性能,可見 JIT 的威力 😁
事已至此,我有點好奇控制流拍平會對代碼的效率造成何種影響。下面是埃拉托色尼篩法原本的代碼,循環分支這塊是少不了的:
export function primeLt(n: number): number[] {
  const sieve = new Uint8Array(n + 1).fill(1);
  if (n >= 0) sieve[0] = 0;
  if (n >= 1) sieve[1] = 0;

  const limit = Math.floor(Math.sqrt(n));
  for (let p = 2; p <= limit; p++) {
    if (sieve[p] === 1) {
      for (let j = p * p; j <= n; j += p) sieve[j] = 0;
    }
  }

  const primes: number[] = [];
  for (let i = 2; i <= n; i++) if (sieve[i] === 1) primes.push(i);
  return primes;
}
一通拍平過後,這個代碼變成鬼👻 了:
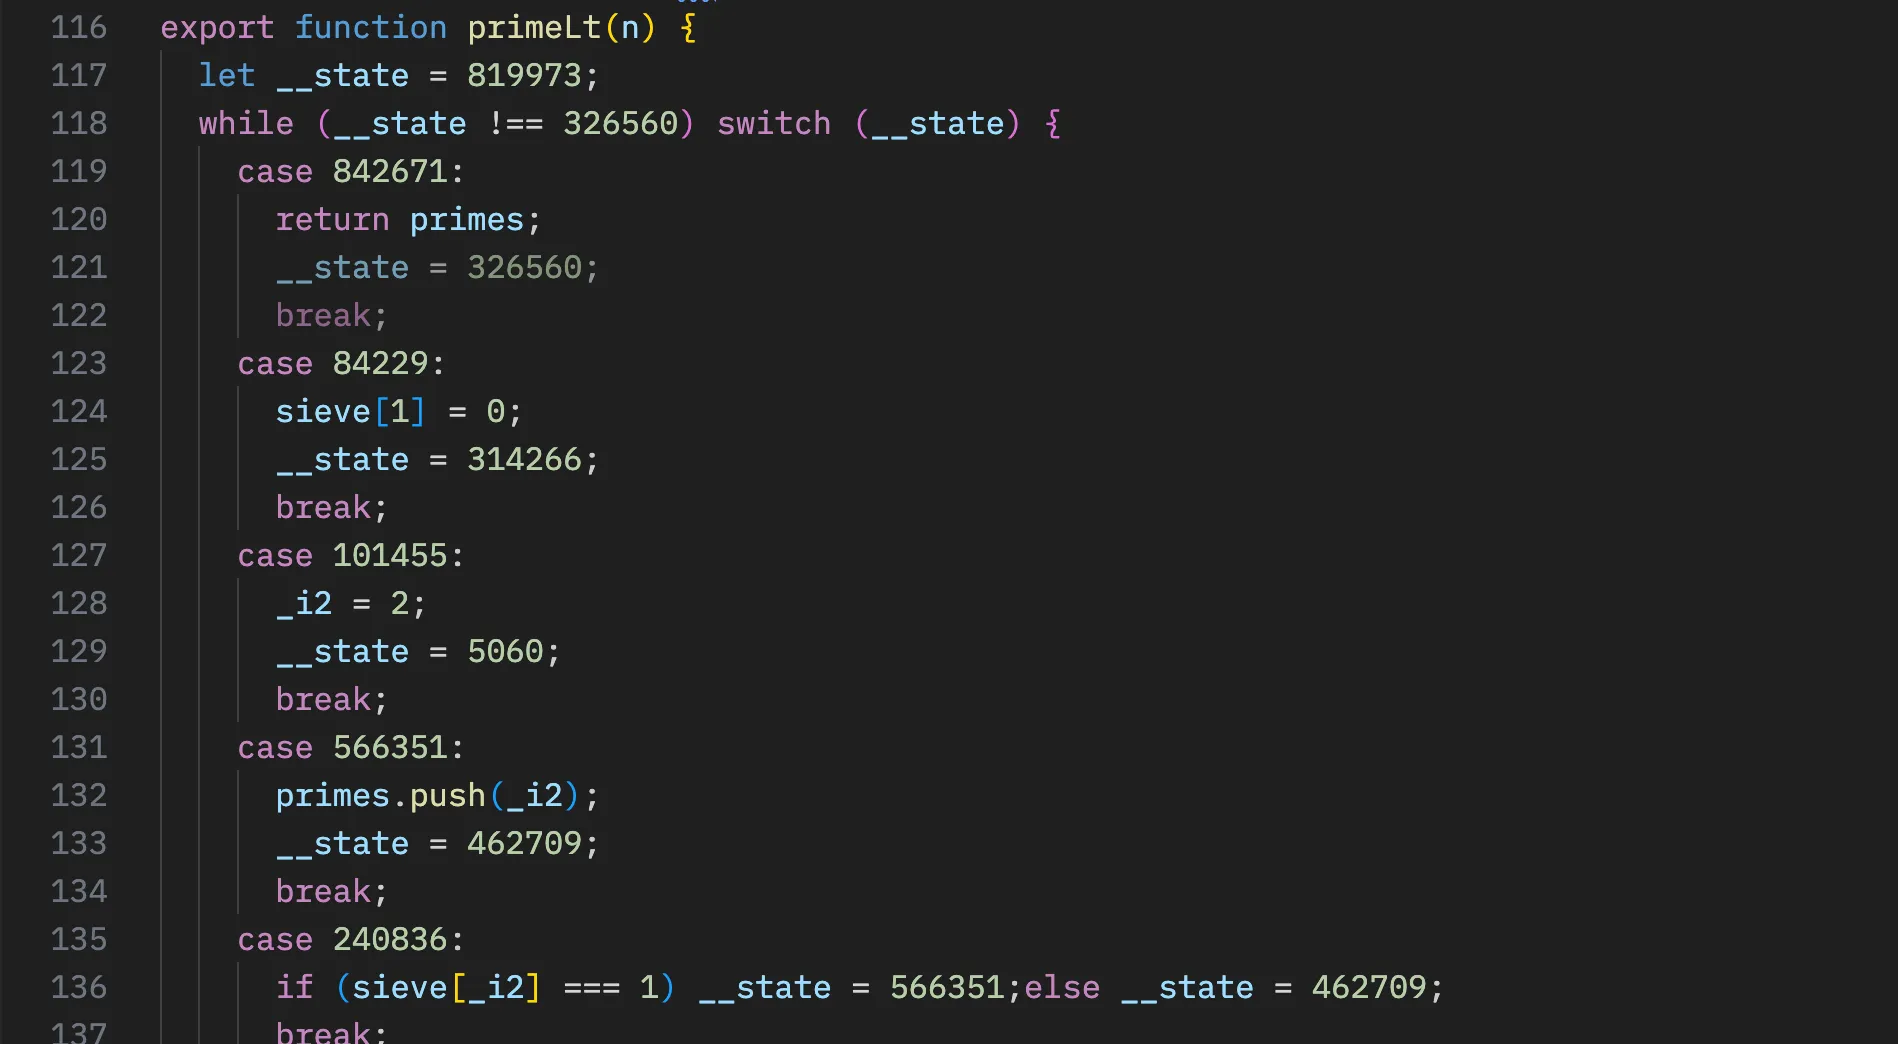
直接開跑:
表 1:篩法不同實現的性能比較
| Implementation | Source | Time (s) | vs. Python fastest |
|---|---|---|---|
primeLt — Uint8Array | TypeScript | 0.440 | 3.6× |
prime_lt_byte — bytearray slice-assign | Python | 1.568 | 1.0× |
primeLt — Uint8Array (flattened) | TypeScript | 1.784 | 0.88× |
將 Python 的 prime_lt_byte 實現作為對比的基準線,發現 JS 的 JIT 可以帶來 3.6 倍的性能提升,然而在拍平過後,JIT 的優化直接嘎了,跑得還不如 Python 快。我覺得這是 for 循環被拆散以後,編譯器就沒法對熱點數據進行優化,同時到處亂跳的 switch 干擾了分支預測導致的,此時性能被幹回了完全沒有優化的起跑線上。
結論:JS 控制流拍平對高頻計算的循環影響較大,悲觀情況下性能可以去和 Python 坐一桌 😇
但是話又說回來,Python 就算性能再爛,循環每秒計算個幾萬次仍然毫不費力,因此控制流拍平帶來的性能惡化在多數情況下都可以忽略不計,其帶來的代碼保護效果對於性能不敏感的場景仍然有用……嗎?
讓我們來考慮一個保護遊戲代碼、防止作弊的應用場景。下面是一個從 👉🏻GitHub 上剽竊來的小遊戲 Flappy Bird,代碼經過拍平。現在請妳打開瀏覽器 F12 的 Debugger,看看妳要花多久才能把那隻鳥改成無敵模式 😁
按 W 鍵開始遊戲
我已經幫妳看過了,代碼裏面確實充斥了大量的 switch case 啊,但是由於變量名沒有混淆,我僅僅花了 30 秒就找到了那個關鍵的判定分支,妳也快來試試吧 😁
結語:不知正焉知逆
我研究控制流拍平的最初目的是為了解開它,亦或是為了防止別人解開它。很久以前我在為某小衆語言軟件寫殼的時候,就用了控制流拍平的手法,然而當時我沒有編譯器,也沒有 AST,代碼混淆純靠手敲。現在想來當年的我也是年輕氣盛,特別愛在沒有任何理論基礎的情況下強行去碰瓷一些難題,然而最終多半是激流勇退並空手而歸。
但是我並沒有後悔以前的做法,誰讓我以前有得是時間呢 😇 有時間,愛走彎路,真是年輕後生的浪漫啊!然而現在我發現,學習這些東西其實並不算難,這不一定是因為我的「水平」有所長進,也許只是因為我已經習慣於工程思維:把問題拆分、再拆分,就像控制流拍平的結果乍看之下如同不可名狀之物,但它其實也只是把 AST 一步步拆分、編號、重組之後的產物而已。
俺覺得,寫殼和做代碼混淆其實有相當大的區別。寫殼(尤其是在 Windows 下寫殼)本質上是一門電腦考古學,加密者和逆向者比的是誰對 40 年屎山理解更深,誰噴糞更不要臉,誰埋的雷更猥瑣;他們明知自己插的暗樁會在下一次 Windows 更新中藍屏,卻仍然不能自拔。而代碼混淆更像是基於電腦科學和數學的優雅博弈,擁有一種純粹的美感。許多逆向工程教材,如『逆向工程核心原理』『加密與解密』都花費了巨大篇幅講述 Windows 那些陳年老福,而非代碼混淆背後的算法和原理,其內容安排過於偏向遠古屎山而非未來展望,我覺得這是非常可惜的。
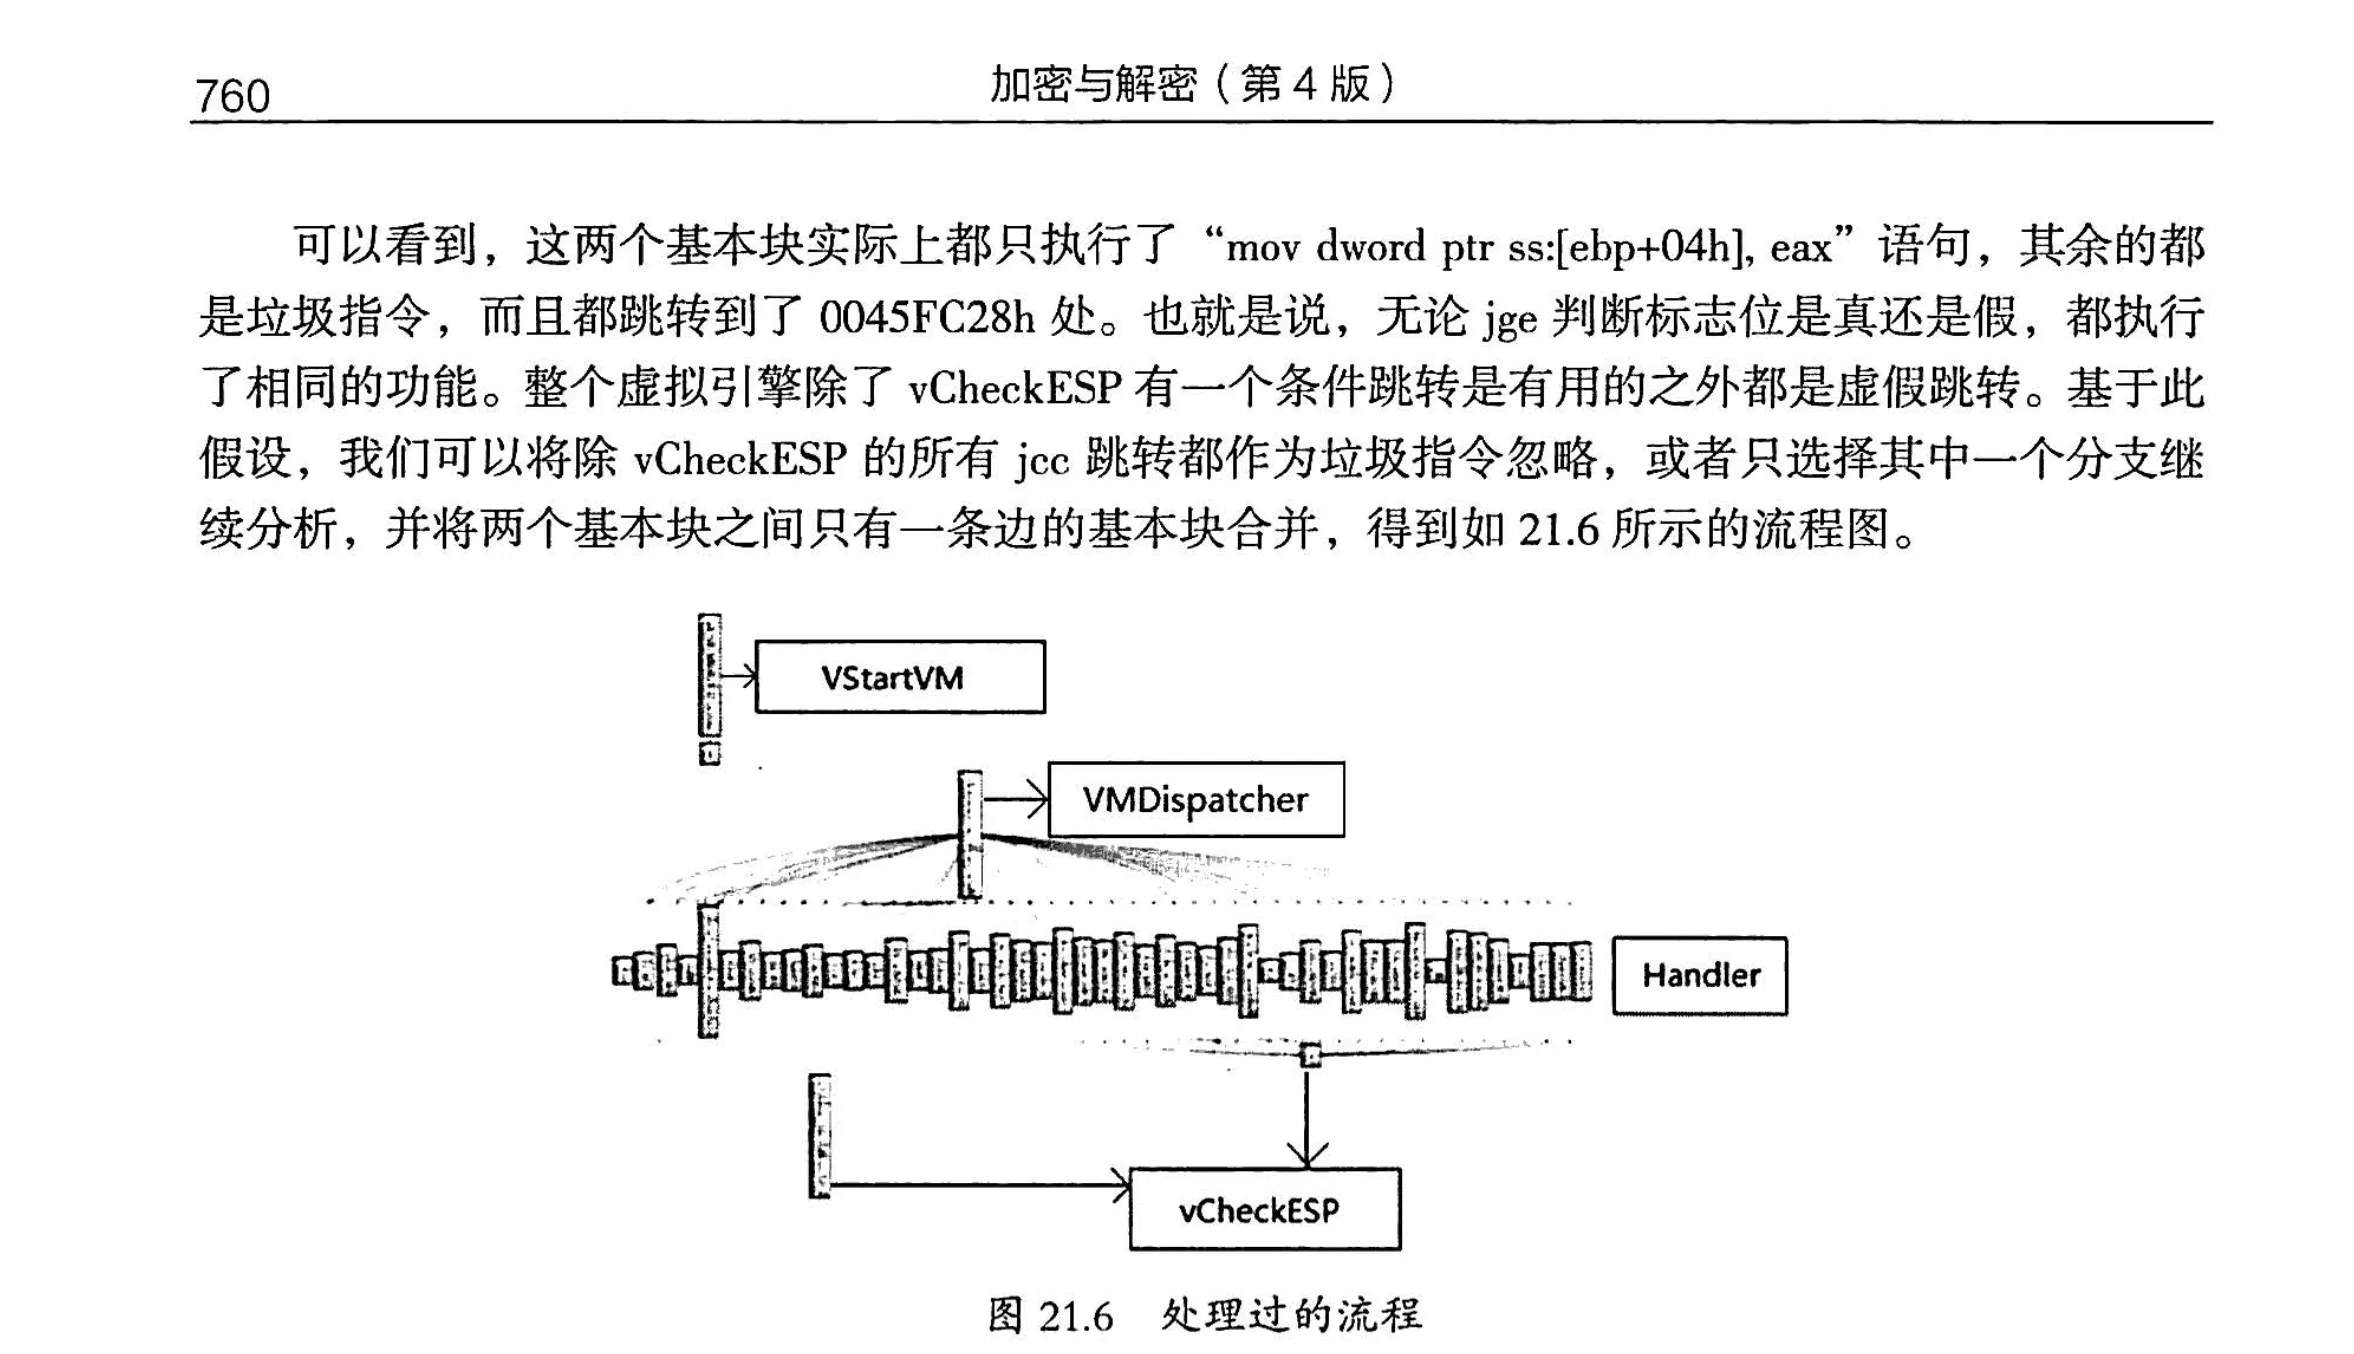
在之後的下篇中,我會嘗試親自破解我做出來的這一套控制流拍平混淆。預計內容將會涉及自動化狀態跟蹤、控制流圖大恢復術和語法樹節點重建,還會一腳踏穿圖論算法和反編譯算法的領域。
我還需要一些時間去收集這些知識點。群友們請稍等喵!下次再見。
參考
Footnotes
-
J. Davidson, C. Wang, J. Hill, and J. Knight, “Software Tamper Resistance: Obstructing Static Analysis of Programs,” University of Virginia, Department of Computer Science, Jan. 2000. doi: 10.18130/V36T9V. ↩
-
T. László and Á. Kiss, “OBFUSCATING C++ PROGRAMS VIA CONTROL FLOW FLATTENING,” 2009. Accessed: Sep. 20, 2026. [Online]. Available: 👉🏻Link ↩
 請停用 Dark Reader
評論區
妳的留言會讓我的文章睜開眼睛,開始呼吸,然後長出新的一部分。
無論是長還是短,俺期待着妳的回覆……
妳也可以給我發電郵。